Algoritmus a vazba na program
| Stránky: | Moodle ZČU |
| Kurz: | KPV/TI Technická informatika ve strojírenství - šablona |
| Kniha: | Algoritmus a vazba na program |
| Vytiskl(a): | Nepřihlášený host |
| Datum: | neděle, 8. listopadu 2026, 16.21 |
Popis
Je důležité si uvědomit, že dosud počítače nejsou schopné zcela samostatného myšlení. Pro provádění výpočtů a obecně zpracování dat je třeba vytvořit jasné postupy - algoritmy zpracování.
1. Algoritmus a vazba na program
Asi každý z nás někdy musel řešit nějaký problém. Intuitivně využíváme našich schopností a podnikáme jisté kroky, abychom nalezli možná řešení zmiňovaného problému.
Pokud bychom se podívali zblízka na samý začátek procesu řešení, musíme nejprve jasně formulovat problém. Tento problém bychom měli co nejvíce analyzovat a určit výchozí podmínky, za kterých hodláme problém řešit. Je pro nás také samozřejmostí, že požadujeme výsledky a mnohdy známe i jejich formu.
Nejinak je tomu i při sestavování postupu řešení konkrétní úlohy pomocí počítačového programu. Celý postup řešení problému za využití počítačového programu lze rozdělit do několika fází - viz Obrázek 1.
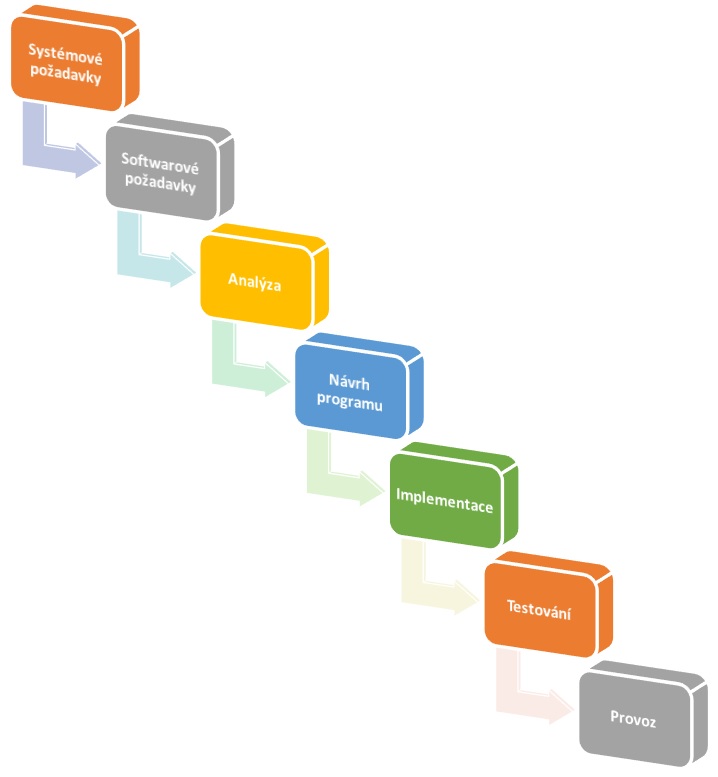
Obrázek 1: Vodopádový model
Tento model zahrnuje následující kroky:
- Systémové požadavky
- Softwarové požadavky
- Analýza - formulace problému, analýza problému, vytvoření postupu řešícího problém, jinak řečeno algoritmus
- Návrh programu - sestavení programu v návaznosti na algoritmus
- Implementace
- Testování
- Provoz
Algoritmus lze tedy popsat jako schématický postup (předpis) pro řešení určité skupiny (třídy) úloh, prováděný v konečném počtu přesně definovaných kroků. Z předchozí věty lze odvodit, že základními vlastnostmi algoritmů jsou:
Hromadnost - řešit skupinu úloh lišících se parametry nebo počátečními podmínkami (např. průměr z počtu N čísel, kde požadujeme, aby N > 0)
Rezultativnost - musí existovat cesta, kterou se dojde od vstupních k výstupním datům - úloha musí konvergovat k výsledku
Konečnost - k výsledkům se musí dojít v rozumně konečné době
Determinovanost - v každém kroku algoritmu musí být jednoznačně dáno, jaká činnost bude následovat
Smyslem programování je vytvořit předpis
pro jednoznačné a v konečném čase opakovatelně uskutečnitelné
řešení konkrétní úlohy, probíhající nad vstupními a výstupními
(vytvářenými) daty. Prostředkem programování jsou programovací
jazyky. Programovací jazyk představuje tedy pro programátora prostředek
vzájemné vazby mezi algoritmickým řešením úlohy a jejím skutečným
řešením na úrovni strojového kódu vlastním počítačem.
1.1. Softwarové požadavky
Po definování všech požadavků, které bychom chtěli vyřešit, bychom také
neměli zapomenout na analýzu následujících částí: [1]
- Typ aplikace – např. konzolová aplikace, desktopová aplikace (grafické uživatelské prostředí – anglicky „Graphical User Interface“– GUI), Client-Server aplikace (jednovrstvá, dvouvrstvá, třívrstvá atd.), webová aplikace, mobilní aplikace atd.
- Architektura softwaru – aplikace s přímým přístupem k datům, víceuživatelský přístup, architektura orientovaná na služby - SOA – anglicky „Service Oriented Architecture“ atd.
- Programovací jazyk – jazyk vhodný pro implementaci algoritmu např. C#, Java, PHP, Python, Ruby, JavaScript, C++ atd., nebo možná kombinace jazyků
- Technologie, kterou bude aplikace využívat:
- Platforma (Microsoft .NET, Java EE, LAMP, nebo jiné)
- Databázový server (Oracle, SQL Server, MySQL, NoSQL databáze nebo jiná)
- Technologie pro uživatelské prostředí (Windows Forms, WPF - Windows Presentation Foundation, JavaServer Faces, ASP.NET, Flash atd.)
- Technologie přístupu k datům (ADO.NET Entity Framework, Hibernate, JPA atd.)
- Technologie pro reporty (SQL Server Reporting Services, Jasper Report atd.)
- Další možné kombinace technologií, které budou využity při implementaci softwaru
1.2. Formulace problému
Formulace problému je přesný popis toho, co se má řešit. Definici problému je třeba věnovat velkou pozornost, neboť chyby, které se zde mohou vyskytnout, se odstraňují velmi nákladně. Ukazuje se, že zejména pro velké projekty platí, že definici problému je věnováno asi 5 % celkového času a nákladů, a problémy vzniklé z nesprávné definice mohou dosahovat až 80 % nákladů na údržbu.
K tomu se používají různé metody datové a funkční analýzy, které musí zejména specifikovat:
- Chování systému, především z hlediska jeho budoucího uživatele
- Vstupní data (struktura, formát dat a jejich typy, množina přípustných hodnot - datová doména)
- Výstupní data (struktura, formát dat a jejich typy)
- Výjimečné situace (např. požadovanou reakci na chybná vstupní data)
Během definice problému je třeba velmi pečlivě zvážit odpovědi na tyto otázky:
- Co?
- Proč?
- Kdy?
- Jak?
- S kým?
- Za kolik?
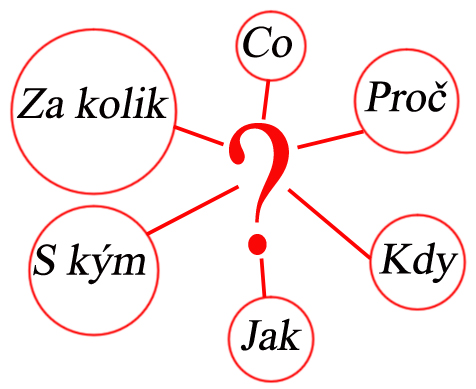
Obrázek 1: Definice problému
1.3. Analýza problému
K analýze problému lze využít některé z běžně používaných metod např. Brainstorming – generování co největšího množství nápadů k danému problému za účasti lidí v různých rolích, obousměrné plánování – kombinace přístupů Top-Down (dekompozice cíle v horní úrovni až po rozpracování a konkretizace způsobů jak implementovat cíle v dolní úrovni, které vedou ke splnění cíle v horní úrovni) a Bottom-Up (stanovení cílů a jejich dosažení z pohledu zdola nahoru), kde jsou odchylky průběžně koordinovány a dochází k jejich ladění, atd. Pro začátečníky je vhodné doporučit postup shora dolů, který je názornější.
Jak si lze všimnout, při analýze se používají obecné postupy:
-
Dekompozice – postupné dělení problémů na menší, nebo slovy klasika Divide et impera! – rozděl a panuj. Tento přístup je základním přístupem v informatice, jenž dekomponuje programového řešení problému na sadu samostatných programů a podprogramů. Je známo, že kratší programy se píší a ladí snadněji než dlouhé. Tuto závislost lze odhadnout empiricky zjištěným vzorcem:
N = k* D1.125
kde:
-
- N jsou náklady na program v korunách nebo člověkohodinách
- k je vhodná konstanta
- D je počet řádků v tisících
Závislost je tedy podstatně horší než lineární v neprospěch větších programů
-
Hierarchie – je vhodné najít hierarchické závislosti jednotlivých částí v systému. Popsáním jejich vzájemných vazeb, může vést k výraznému zjednodušení
-
Abstrakce – oddělení podstaty řešeného problému od detailů, tj. ignorace detailů, které nemají žádný významný vliv na řešení problému
Sice existuje řada pravidel, která pomáhají při analýze a plánováni, ale důležitá je také dobrá intuice, dovednosti a tzv. selský rozum.
1.4. Popis algoritmu
Při sestavování algoritmu, tedy postupu, jak řešit daný problém, je vhodné využívat obecné postupy, tj. dekompozice, hierarchie a abstrakce uvedené v předchozí kapitole.
K formálnímu popisu algoritmu se používají různé metody, které většinou kvůli názornosti využívají různé stupně grafického zobrazení. Nejznámější grafické metody popisu algoritmů jsou vývojové diagramy (nebo v dřívějších dobách používané struktogramy – rozdělení na jednotlivé bloky), k vyjádření rozkladu problému pak hierarchické diagramy.
Ve všech případech plní metody popisu algoritmu jednu nebo více z následujících funkcí:
- Vývojovou
- Komunikační
- Dokumentační
Podle toho, do jaké detailní hloubky je algoritmus popsán, rozlišujeme vývojové diagramy hrubé a detailní.
Dobrý a přehledný popis algoritmu za použití některé grafické metody bývá často, zvláště u začátečníků, podceňován. Také moderní interaktivní přístupy k programování s rychlým cyklem oprava – překlad - spuštění programu svádí k tomu, aby byl tento stupeň vývoje vynechán. Toto zdánlivé zrychlení práce má své opodstatnění jen pro problémy, které nejsou rozsáhlé a které řešitel udrží ve své hlavě po celou dobu vývoje. Tento případ nastane v praxi jen velmi vzácně. Navíc, musí-li se řešitel po nějaké době k algoritmu vrátit, nastanou problémy, neboť řešitel musí pracně luštit to, co v minulosti vymyslel, ať už on nebo (což je ještě horší) někdo jiný.
Někdy, zvláště v publikační činnosti, se k popisu algoritmů používá
některého všeobecně známého vyššího programovacího jazyka.
1.5. Vývojový diagram
Vývojový diagram (anglicky „Flowchart) je velmi názornou pomůckou v začátcích výuky programování. Detailně postihuje všechny možnosti průběhu zpracování programu a jeho větvení na základě testů podmínek. V nedávné minulosti byla metoda vývojových diagramů preferována, a dokonce existovala závazná československá norma (ČSN) značek a způsobu jejich kreslení. V současné době se již tato norma neužívá a je ponecháno na řešiteli, jak se s problémem vyrovná. Existují však doporučení, která, jsou-li důsledně dodržována, se jeví velmi užitečná.
Při kreslení vývojových diagramů se vyžívají značky pro bloková schémata, které se propojují pomocí orientovaných čar. Doporučený směr kreslení je shora dolů a zleva doprava. Při větší složitosti problému se vývojový diagram stává nepřehledný a může vést k vytvoření částí programů se skrytými vedlejšími efekty.
Značky používané ve vývojovém diagramu lze rozdělit na: [2]
Mezní značky – představují vstup do algoritmu nebo výstup z algoritmu. Používají se také pro specifikaci začátku nebo konce podprocesu (v programování podprogramu) v algoritmu. Mají vždy jen jednu orientovanou čáru – vstupní nebo výstupní
Sekvenční bloky – označují sekvenční postup (provádění) algoritmem. Lze se do něj dostat pouze z předchozího prvku a po jeho vykonání lze postoupit na následující prvek. V jejich průběhu nesmí dojít k rozvětvení algoritmu. Příkladem sekvenčního bloku je blok vstupu, výstupu, proces
Větvení – k větvení dochází na základě podmínky (ne nahodile). Je-li podmínka splněna, v algoritmu se pokračuje příslušnou větví
Další značky – mezi další značky lze zařadit cykly, podproces, spojovací prvky, atd.
Pro ilustraci záznamu algoritmu do podoby vývojového diagramu použijeme několik ilustrativních příkladů, které nám pomohou pochopit podstatu jednotlivých základní značek používaných při tvorbě vývojového diagramu. Vývojový diagram budeme vytvářet pomocí aplikace Flowgorithm (http://www.flowgorithm.org/). Existuje také jiné aplikace pro tvorbu vývojových digramů, např. MS Visio, Draw.io, atd.
1.6. Mezní značky
Jako první značka ve výčtu základních značek používaných ve vývojovém diagramu je značka začátku algoritmu, nebo jeho bloku - v oblasti programování tento blok standardně představuje hlavní program (v C# je program, nebo podprogram nazývaný obecně jako metoda). Uvnitř mezní značky (angl. „Terminal“) bývá zpravidla uváděn název příslušného algoritmu. V našem případě bude uveden název hlavního programu - Main - viz Obrázek 1. Můžete se také setkat se značením počáteční značky algoritmu, která je uvedena slovem Začátek (anglicky „Start“). Tento program je spuštěn jako první.
Na konci algoritmu, nebo jeho bloku je uváděna tvarově shodná značka. V našem případě značka konce algoritmu je uvozena slovem End. Jak si můžeme všimnout, ke koncové mezní značce vede šipka. V algoritmu musí být zaznamenán směr od které značky a ke které značce bude algoritmus prováděn.
Pozn.: Můžete se také setkat s případy, kdy značka konce algoritmu může nést stejný název algoritmu, jako je uveden v počáteční značce.
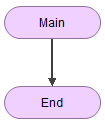
Obrázek 1: Značka začátku a konce algoritmu
1.7. Sekvenční bloky
Deklarace proměnné
Algoritmy (včetně programů) v převážné většině pracují s daty a tato data potřebují uchovávat. Za tímto účelem využíváme proměnnou (anglicky „Variable“), kterou lze vnímat jako pojmenovaný šuplík (v programu vymezený úsek paměti), do kterého lze ukládat data. Lze tedy logicky odvodit, že hodnota proměnné se v průběhu algoritmu mění. Proměnná je pojmenovaná svým pevným názvem. Tento název by měl být v konkrétním bloku algoritmu jedinečný, tzn., v konkrétním bloku algoritmu by se neměly vyskytnout dvě nebo více proměnných se stejným názvem. U názvu proměnných budeme psát malé počáteční písmeno. Název proměnné se používá k označení hodnoty, která je do ní uložena, a měl by dostatečně vystihovat podstatu proměnné, např. proměnná týkající se věku by měla být pojmenována jako vek a ne x39. Název proměnné by neměl být příliš dlouhý, nebo příliš krátký. Názvy proměnných by se neměly lišit pouze v počátečním písmenu, protože může dojít k jejich záměně např. MojePromenna vs mojePromenna.
U víceslovných názvů proměnných budeme využívat tzv. velbloudí notaci (anglicky „Camel Case“), která označuje způsob psaní víceslovných nadpisů, v nichž jednotlivá slova nejsou oddělena mezerami, ale každé z nich začíná velkým písmenem.
V programování se specifikací proměnné rozumí tzv. deklarace proměnné. Pod slovem deklarace (anglicky „Declaration“) si představme specifikaci názvu proměnné a typu hodnoty tzv. datového typu (anglicky „Data Type“), kterou proměnná bude obsahovat. Vzhledem k tomu, že pro tvorbu algoritmů budeme využívat nástroj Flowgorithm, uveďme si základní značku deklarace proměnné - viz Obrázek 1.
Obrázek 1: Značka deklarace proměnné
Aplikace Flowgorithm umožňuje při deklaraci proměnné používat následující základní datové typy:
-
Integer - pokud má proměnná v sobě uloženo celé číslo
-
Real - reálné číslo
-
String - textový řetězec (řetězec jednotlivých znaků)
-
Boolean - logická proměnná (hodnota True, False)
Datové typy by neměly být použity jako tzv. identifikátor, tj. např. název proměnné, název algoritmu atd.!
Přiřazení hodnoty proměnné
Vzhledem k tomu, že již víme, jak deklarovat proměnnou, měli bychom také vědět, jak do ní přiřadit (uložit) hodnotu. K tomu využijeme značku přiřazení (anglicky „Assign") - viz Obrázek 2.
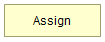
Obrázek 2: Značka přiřazení hodnoty proměnné
Značka tvoří základní prvek algoritmu, jež se zpravidla zabývá zpracováním dat. Z formálního hlediska může jít o jeden příkaz, i když je vnitřně složitě strukturovaný. Obdélníková značka vyjadřuje tzv. příkaz (anglicky „Statement“). Nejčastějším příkazem je přiřazovací příkaz, který má tři části:
- Proměnnou, kam se přiřazuje hodnota,
- Operátor přiřazení ( jazyce C# =, v jiných jazycích také :=).
- výraz (anglicky „Expression“), tzn., vše, co může v algoritmu po svém vyhodnocení nabýt nějaké hodnoty.
Nejjednodušším výrazem je konstanta. Složitějším výrazem je proměnná a ještě složitějším je výraz, složený z proměnných a konstant spojených povolenými operátory (podle typu proměnných a konstant). Povolené operátory aritmetických výrazů jsou známé operace jako: sčítání „+“, odečítání „-“, násobení „*“, podíl „/“, nebo systém závorkování „(…)“. Při vyhodnocování aritmetických výrazů se vyhodnocuje zleva doprava, přičemž operátory násobení a podílu mají vyšší prioritu (jsou prováděny dříve) než sčítání a odečítání. Prioritu vyhodnocování lze měnit závorkovou skladbou.
Následující tabulka obsahuje aritmetické operátory, které lze využít ve vývojových diagramech – viz Tabulka 1. Značky aritmetických, relačních a logických operátorů, které jsme zvolili, jsou využity s ohledem na návrh algoritmů pro programovací jazyk C#. V tabulce proto také naleznete možné další zobrazení matematických a dalších operátorů, se kterými se můžete setkat v různých studijních zdrojích. Pokud jste se nesetkali s pojmy jako je celočíselné dělení (dělení dvou celých čísel) a zbytek po celočíselném dělení, přečtěte si následující odstavec.
Pro operaci celočíselného dělení budeme ve vývojových diagramech používat značku /. Pro zbytek po celočíselném dělení (MODULO) budeme používat značku %. Uveďme si příklad celočíselného dělení: 7 / 2 = 3. Dvojka se vejde celá do sedmičky celkem třikrát. U zbytku po celočíselném dělení: 7 % 2 = 1. Dvojka se do sedmičky vešla celá třikrát. Jednička je zbytek po celočíselném dělení (o kolik se dvojka nevešla celá do sedmičky), tedy 7-(2*3) = 1.
|
Operátor |
Operace |
Příklad |
Možná další označení – nebudeme používat! |
|
+ |
Sečtení |
x + y |
|
|
- |
Odečtení |
x – y |
|
|
* |
Násobení |
x * y |
|
|
/ |
Dělení (celočíselné dělení) |
x / y |
DIV … celočíselné dělení |
|
% |
Modulo – zbytek po celočíselném dělení |
x % y |
MOD |
|
^ |
Umocnění |
x^2 … druhá mocnina – v matematickém zápise x2 |
SQR … druhá mocnina čísla |
|
SQRT |
Druhá odmocnina |
SQRT (x) …samozřejmě lze použít převrácenou hodnotu mocniny x^0.5 |
|
Tabulka 1: Aritmetické operátory
Povolené operace v sekvencích jsou: rozdíl, součin, mocnina, logický součet, logický součin, negace. U podílu (popřípadě celočíselné dělení) lze dělit dvě čísla pouze tehdy, když je jmenovatel různý od nuly. Pokud tomu tak není, výsledkem je neurčitá hodnota a tuto vlastnost musíme v algoritmu ošetřit např. větvením, což už není sekvence!
Operace, které nejsou v sekvencích povolené: podíl (např. dělení nulou), celočíselné dělení, odmocnina (např. odmocnina záporného čísla), jakákoliv forma cyklu. Odmocnina – pokud neprovádíte výpočty s komplexními čísly, pak výraz pod odmocninou nesmí být záporný. V algoritmu musíme tento jev ošetřit např. větvením, což už není sekvence! [2]
Hodnotu proměnné lze také naplnit v jiném zavolaném podprogramu - v C# programování obecně metodě (proceduře), nebo ji lze přiřadit výstup z jiného podprogramu (výstup funkce). Ve starších vývojových diagramech lze najít jako značku přiřazení symbol ←. Tato značka již ale není dnes zpravidla využívána.
Pro větší úsporu místa ve vývojovém diagramu je také někdy napsáno více příkazů nebo výrazů v rámci jednoho bloku přiřazení. Jednotlivé příkazy jsou specifikovány na řádcích pod sebou. Tento přístup však někdy znesnadňuje čitelnost algoritmu.
Komentář
U algoritmů je zpravidla vhodné doplnit u jednotlivých prvků vlastní popisek, tzv. komentář (anglicky „Comment“) – viz Obrázek 3. Značka komentáře patří do skupiny Další značky, ale značka této dodatečná informace (popisující např. podstatu prvku) často uživateli pomůže rychle pochopit již dříve vytvořený algoritmus, ke kterému se po čase vrátil. Proto jsme tuto značku vysvětlili již nyní. Komentář nemá vliv na algoritmus (v programování na kód).
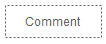
Obrázek 3: Značka komentáře
Blok výstupu
Pokud potřebujeme zobrazit tzv. výstup (anglicky „Output“), tj. např. vypsat text, nějaká data, vypsat hodnotu uloženou v proměnné, zapsat data do souboru apod., použijeme pro blok vstupu značku, která má tvar kosodélníku - viz Obrázek 4.
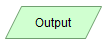
Obrázek 4: Značka výstupu
Pozn.: Protože pro vývojové diagramy nejsou omezeny normou, lze u českých vývojových diagramů nalézt podobné termíny jako: Piš, Vypiš, Zobraz, Tiskni, u anglických zase: Write, Print, Display apod. Za účelem sjednocení různých názvů pro jednu a tu samou činnost, budeme u bloků výstupu používat slovo Output.
Následující příklad ukazuje značku výstupu pro výpis textu "Hello, World!". Text je uvozen a zakončen horními uvozovkami " " – Obrázek 5.

Obrázek 5: Značka výstupu – příklad vypsání textu
Algoritmus HelloWorld
-
Popis: Vývojový diagram výpisu textu "Hello, World!"
-
Zadání: Zkuste vymyslet, jak byste zaznamenali výpis textu pomocí vývojového diagramu, včetně komentáře, který popisuje, co daná značka výpisu provádí
Algoritmus HelloWorldPromenna
-
Popis: Vývojový diagram výpisu proměnné s názvem osloveni v níž je uložen text "Hello, World!"
-
Zadání: Zkuste vymyslet, jak byste zaznamenali výpis hodnoty uložené v proměnné pomocí vývojového diagramu, včetně komentářů, které popisují, co jednotlivé značky zajišťují
Blok vstupu
Pro algoritmus je důležité načtení dat, které jsou využity při provádění procesů v algoritmu. Další neméně důležitou značkou je blok vstupu (anglicky „Input“) (někdy též označovaný jako Data). Tato značka kosodélníku je stejná jak pro načtení dat, tak i pro výpis dat - viz Obrázek 6. Proto pokud jsou v algoritmu načítána data, je vhodné uvést uvnitř značky informaci, že jde o načtení dat - slovo Input.
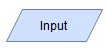
Obrázek 6: Značka vstupu
Pozn.: U českých vývojových diagramů je možné nalézt slova jako: Čti, Načti apod.. Za účelem sjednocení různých názvů příkazu načtení, budeme u bloků vstupu používat anglické slovo Input.
Za slovem Input následuje název nebo názvy proměnných, do kterých budou načteny (uloženy) hodnoty, které jsou vstupem do algoritmu, např. uživatel zadá hodnoty pomocí klávesnice apod.
Hodnoty se do algoritmu zadávají různým způsobem – nejčastěji použitím bloku vstupu (vstupní zařízení naplní určené proměnné např. klávesnice počítače, čtecí zařízení, import ze souboru apod.). Při plnění proměnné musíme dodržet zásady: vstupní seznam může být i prázdný a v seznamu mohou být pouze jména proměnných, které mají být naplněny (nesmí to být např. konstanta nebo jiný výraz. Hodnota konstanty se v průběhu algoritmu nemění a nemusí mít vždy jen číselnou hodnotu).
Algoritmus HelloWorldNacteni
-
Popis: Vývojový diagram výpisu proměnné v níž je uložen text zadaný uživatelem
-
Zadání: Zkuste vymyslet, jak byste zaznamenali výpis hodnoty zadané uživatelem uložené v proměnné s názvem osloveni pomocí vývojového diagramu, včetně komentářů, které popisují, co jednotlivé značky zajišťují
1.8. Větvení
Rozhodovací
blok
Rozhodovací blok (anglicky „Decision“) obecně popisuje rozhodnutí na základě podmínky vepsané uvnitř tohoto bloku – viz Obrázek 1.
Obrázek 1: Značka rozhodování
Podmíněný příkaz vyhodnocuje logický výraz a podle výsledku vykoná jednu z větví označených True, nebo False. Výstup uvozený slovem True z bloku představuje větev, která bude vykonána, pokud je podmínka uvnitř rozhodovacího bloku splněna.
Pozn.: Ve vývojových diagramech lze také nalézt označení větve True např. operátorem +, nebo slovem Ano.
Při nesplnění podmínky bude vykonána větev uvozená slovem False.
Pozn.: Ve vývojových diagramech lze také nalézt označení větve False např. operátorem -, nebo slovem Ne.
Algoritmus PrirozeneCislo- Popis: Test na přirozené číslo
- Zadání: Rozhodněte, zda uživatelem zadané číslo je přirozené číslo. Pokud je číslo přirozené, vypište uživateli zadanou hodnotu. V opačném případě se nestane nic
Následující tabulka obsahuje relační operátory, které lze využít ve vývojových diagramech – viz Tabulka 1.
Operátor | Operace | Příklad | Možná další označení – nebudeme používat |
> | Větší než | x > y |
|
>= | Větší rovno | x >= y |
|
< | Menší než | x < y |
|
<= | Menší rovno | x <= y |
|
== | Rovno | x == y | = |
!= | Nerovno | x != y | # |
Tabulka 1: Relační operátory
Následující tabulka obsahuje logické operátory, které lze využít ve vývojových diagramech – viz Tabulka 2.
Operátor | Operace | Příklad | Možná další označení |
&& | Logický součin – konjunkce (klávesová zkratka na české klávesnici: Alt+38 … nebo … AltGr+C) | x < y && y < z | AND
|
|| | Logický součet – disjunkce (klávesová zkratka na české klávesnici: Alt+124 … nebo … AltGr+w) | x < y || y < z | OR |
! | Negace | ! (x > y) | NOT |
Tabulka 2: Logické operátory
Pojďme si trochu procvičit logiku – viz Tabulka 3. Následující tabulka obsahuje možné hodnoty, kterých může nabývat logická proměnná – true (někdy také označená jako 1, nebo +) vs false (někdy také označená jako 0, nebo -). V programování se tyto proměnné označují jako typ Boolean nebo též logický typ. Ve sloupcích jsou umístěny logické a relační operátory, jejichž aplikací na hodnoty těchto proměnných získáme výsledek. Pro zjednodušení si představte namísto false hodnotu 0 a namísto true hodnotu 1. Pak již stačí násobit (logický součin – konjunkce) nebo hodnoty sčítat (logický součet – disjunkce – pozor 1 + 1 je v tomto případě 1. Hodnota totiž může být 0 nebo 1). V C# se za true považuje každý výraz různý od nuly, false je ve všech bitech výrazu nula.
x | y | x && y | x || y | ! (x) | x == y | x <= y |
false | false | false | false | true | true | true |
false | true | false | true | true | false | true |
true | false | false | true | false | false | false |
true | true | true | true | false | true | true |
Tabulka 3: Logické a relační operátory
Vícenásobné větvení
Mnohdy potřebujeme v algoritmu zaznamenat případ vícenásobného větvení, tzn., z rozhodovacího bloku vystupují více než dvě větve. Jedná se o tzv. přepínač (anglicky „Case“, nebo někdy také „Switch“), kde je nejprve vyhodnocen výraz a na základě jeho výstupu se rozhodujeme, kterou větví se v algoritmu následně vydáme. Pokud ani jedna větev neodpovídá výstupu známky, algoritmus pokračuje ve větvi Default – viz Obrázek 2. V jazyce C# je synonymem této značky příkaz switch (dozvíme se dále). Tuto značku však aplikace Flowgorithm neobsahuje, ale můžeme ji nahradit vnořením dalších bloků s rozhodováním.

Obrázek 2: Vícenásobné větvení
Pokud bychom se nad tímto prvkem zamysleli, lze ho detailněji popsat pomocí následujícího vývojového diagramu, kde je výsledek výrazu sekvenčně porovnán v každém rozhodovacím bloku, tj. Konstanta_.... Pokud hodnota výrazu odpovídá hodnotě v rozhodovacím bloku, je následně provedena příslušná větev. Pokud hodnota výrazu danou podmínku nesplňuje, přechází do další podmínky atd. Pokud ani jedna z podmínek není splněna, pak se v tomto případě provede výchozí (default) větev, mnohdy prázdná - viz Obrázek 3.

Obrázek 3: Vícenásobné větvení - princip vnořených podmínek
Algoritmus Kalkulacka- Popis: Vývojový diagram pro řešení aritmetických operací u dvou zadaných celých čísel
- Zadání: Zkuste navrhnout algoritmus Kalkulacka, který řeší základní aritmetické operace podle zadaného číselného kódu (1 … sčítání, 2 … odečítání, 3 … násobení a 4 … dělení) u dvou uživatelem zadaných čísel a a b
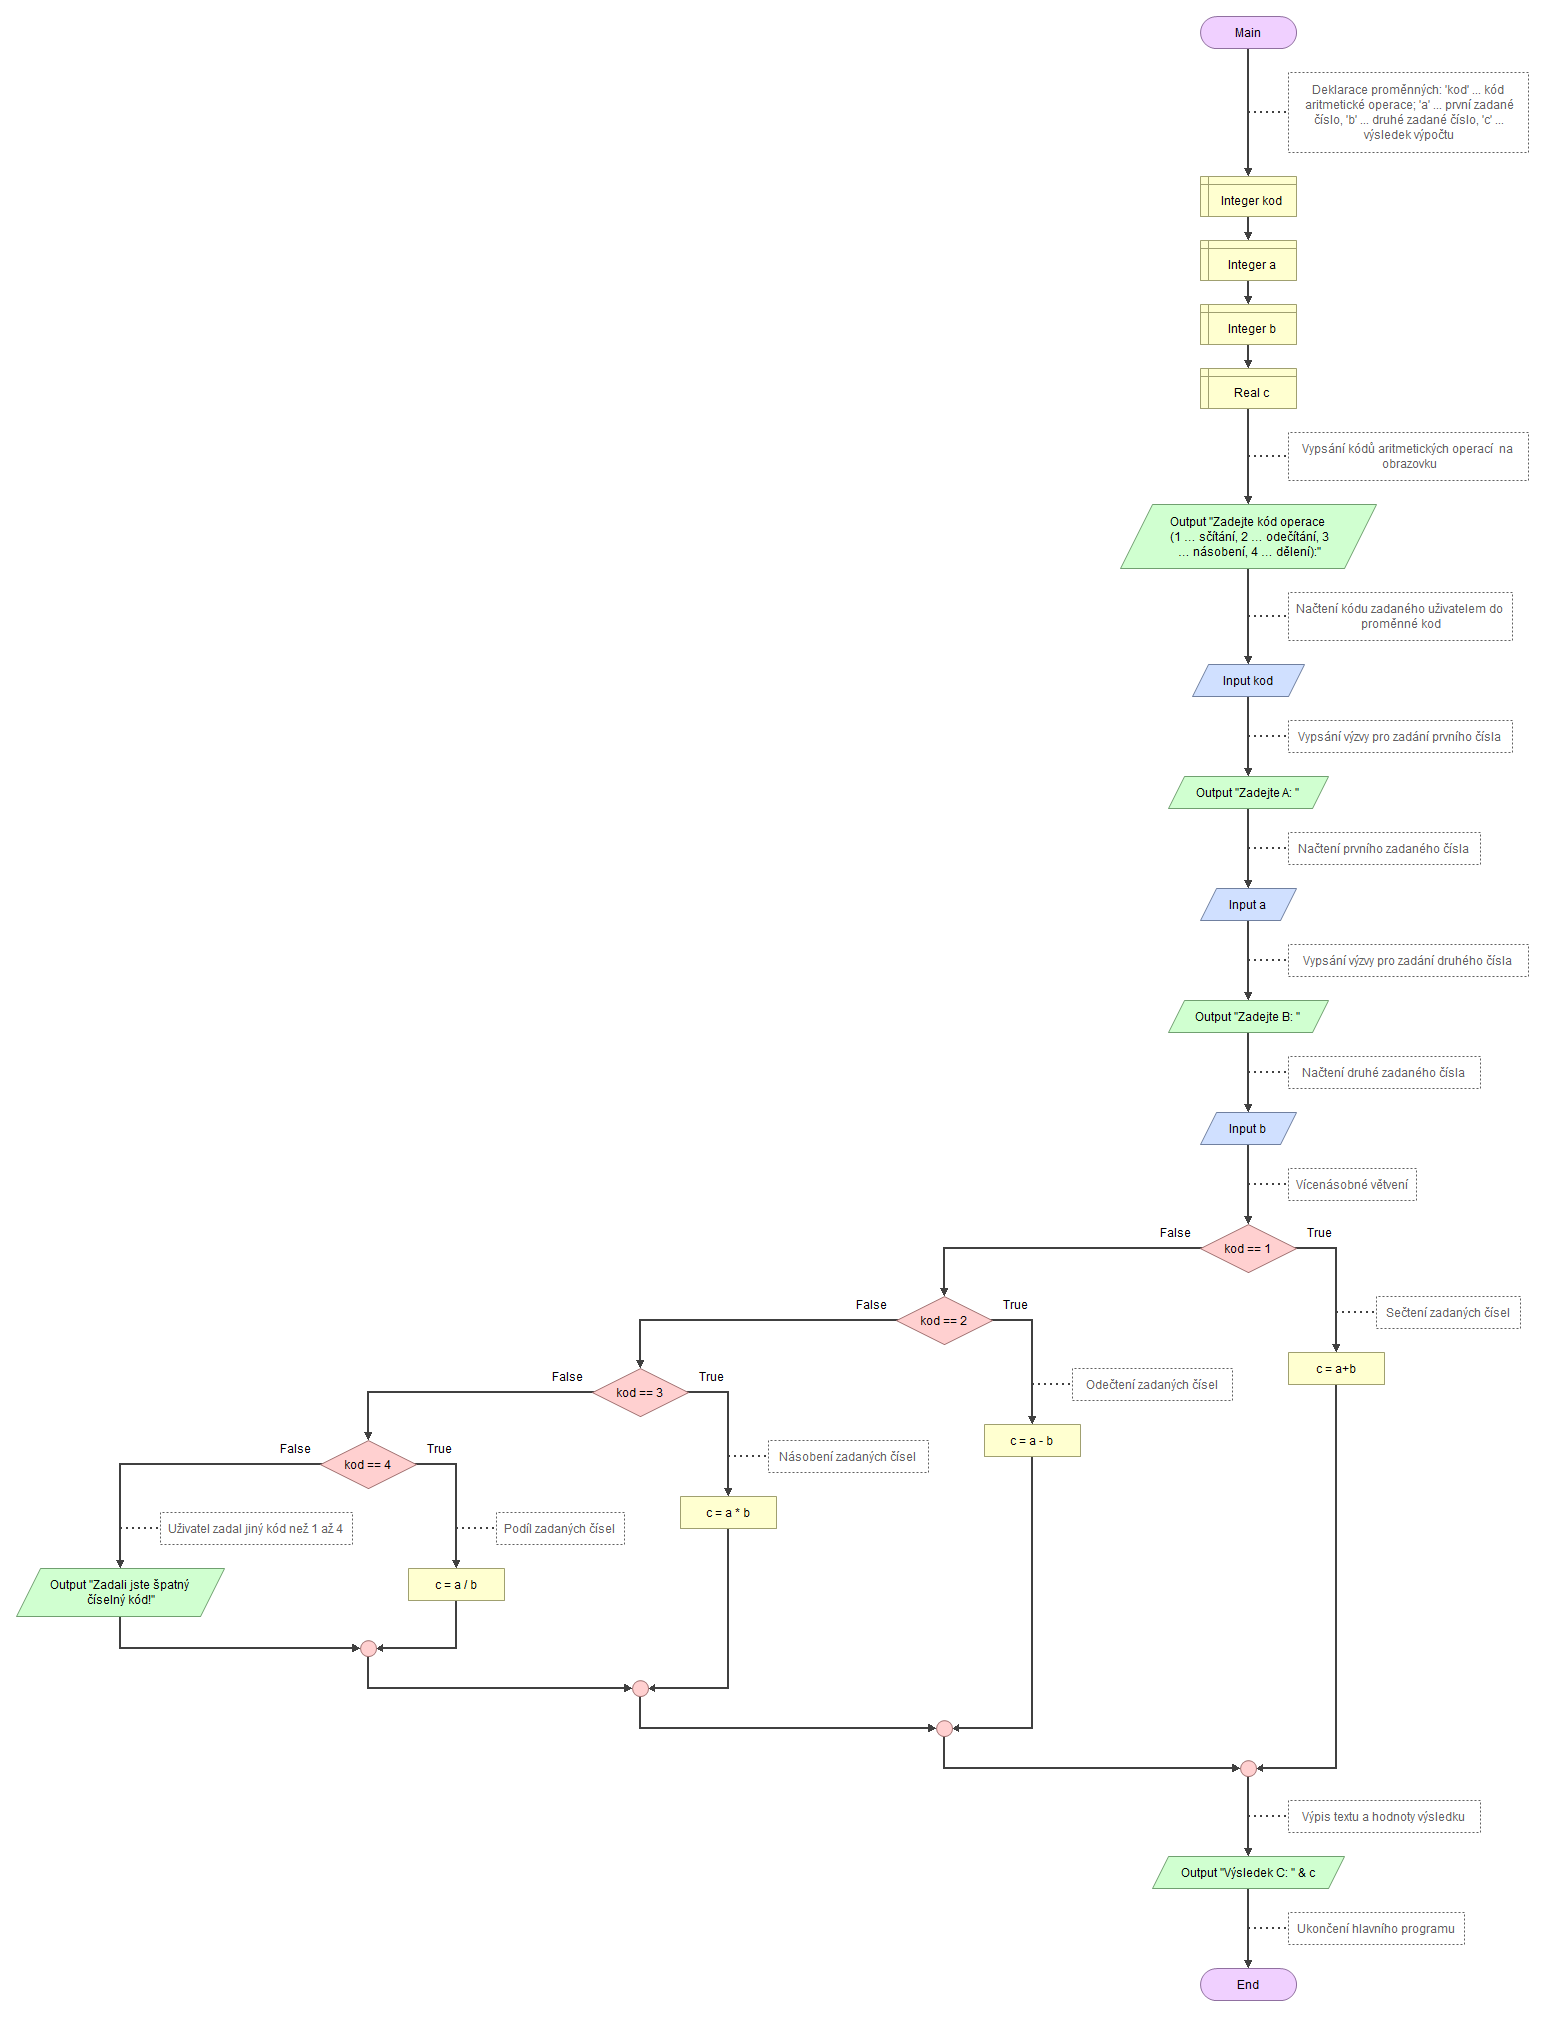
Je důležité zdůraznit, že algoritmus Kalkulacka nezohledňuje možné chyby, které mohou nastat (např. pouhé konstatování "Zadali jste špatný číselný kód" aritmetické operace a nemožnost provést aritmetickou operaci asi nikoho nepotěší). Tímto a dalšími problémy se budeme zabývat v dalších kapitolách tohoto kurzu.
1.9. Podprogram
Jistě jste všimli, že algoritmus může být svojí velikostí poněkud rozsáhlý. Nebylo by tedy vhodné algoritmus zpřehlednit? Zkusíme využít principu tzv. dekompozice – postupné dělení problémů na menší – tedy rozčlenění algoritmu na podprogramy (v C# obecně nazývané metody).
Každý podprogram má značku svého začátku a konce (stejně jako hlavní program). Podprogram je definován svým názvem (je vhodné využít VelbloudíNotaci - každé nové slovo je uvozeno velkých písmenem), který je uváděn v počáteční značce podprogramu. Pokud je zapotřebí nějakých vstupů (např. hodnot, textu apod.) jsou uvedeny v závorce za názvem podprogramu. Takové vstupy (potažmo výstupy) se nazývají parametry. V případě definování, tzv. deklarace podprogramu, zatím nemusí být známy konkrétní hodnoty těchto parametrů. Tyto parametry označujeme jako formální parametry. Tyto parametry nabývají konkrétních hodnot až v rámci provádění podprogramu. U těchto parametrů je uveden datový typ (typ dat, které budou obsahovat), který je uveden před názvem každého parametru podprogramu - viz Obrázek 1.
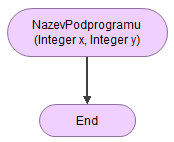
Obrázek 1: Mezní značky podprogramu
Hlavním důvodem proč dekomponovat rozsáhlý program je zejména jeho jednodušší údržba. Velmi často se stává, že se některé příkazy opakují a pokud bychom vkládali kopii tohoto kódu a následně jsme zjistili, že jsme v tomto duplikovaném kódu udělali chybu, musíme tento kód opravovat tolikrát, kolikrát jsme ho duplikovali. Namísto toho, pokud kód umístíme do podprogramu, můžeme tento podprogram několikrát spouštět, tzv. volat (ať už v rámci hlavním programu, nebo podprogramu). Pokud jsme využili podprogram a narazili bychom na chybu v kódu podprogramu, stačí jen opravit kód v podprogramu a bezchybný podprogram stačí jen znovu volat.
K volání podprogramu využíváme následující značku - viz Obrázek 2.
Obrázek 2: Značka volání podprogramu
Pozn.: Podprogramy jsou někdy též obecně nazývány podprocesy - anglicky „Subprocess“.
Podprogram může představovat:
- Funkci - funkce nám zpravidla vrací pouze jeden výstup, ale její výhodou je, že můžeme přiřadit hodnotu výstupu z této funkce zpět do algoritmu, který danou funkci spustil. U funkce budeme uvádět její datový typ výstupu
- Proceduru - procedura nemusí mít žádný výstup, nebo může mít až několik výstupů (nástroj Flowgorithm umožňuje používat pouze funkci, tj. návrat jednoho výstupu! Lze také specifikovat, že funkce nebude mít žádný výstup - jedná se tedy o proceduru)
Algoritmus KalkulackaPodprogramy - Popis: Vývojový diagram pro řešení aritmetických operací u dvou zadaných čísel pomocí podprogramů
- Zadání: Zkuste navrhnout algoritmus, který řeší základní aritmetické operace podle zadaného číselného kódu (1 … sčítání, 2 … odečítání, 3 … násobení a 4 … dělení) u dvou uživatelem zadaných čísel a a b. Vytvořte funkci ZadejCislo ve které naplníte hodnotu čísla, které je argumentem pro některou z aritmetických operací. Tato funkce má vstupní argument NazevParametru, který je názvem aktuálně zadávaného čísla a je vypsán před načtením hodnoty čísla zadaného uživatelem (aby uživatel věděl, který argument právě zadává). Rozdělte aritmetické operace do následujících podprogramů: SectiParametry, OdectiParametry, NasobParametry a VydelParametry, ve kterých budou prováděny příslušné aritmetické operace. Pro zobrazení výsledku výpočtu deklarujte podprogram ZobrazVysledek
- Řešení:
Podprogramy - funkce:
- ZadejCislo: https://phix.zcu.cz/moodle/pluginfile.php/389313/mod_book/chapter/98975/Algoritmus_Kalkulacka_Podprogram_ZadejCislo.png
- SectiParametry: https://phix.zcu.cz/moodle/pluginfile.php/389313/mod_book/chapter/98975/Algoritmus_Kalkulacka_Podprogram_SectiParametry.png
- OdectiParametry: https://phix.zcu.cz/moodle/pluginfile.php/389313/mod_book/chapter/98975/Algoritmus_Kalkulacka_Podprogram_OdectiParametry.png
- NasobParametry: https://phix.zcu.cz/moodle/pluginfile.php/389313/mod_book/chapter/98975/Algoritmus_Kalkulacka_Podprogram_NasobParametry.png
- VydelParametry: https://phix.zcu.cz/moodle/pluginfile.php/389313/mod_book/chapter/98975/Algoritmus_Kalkulacka_Podprogram_VydelParametry.png
Podprogram - procedura:
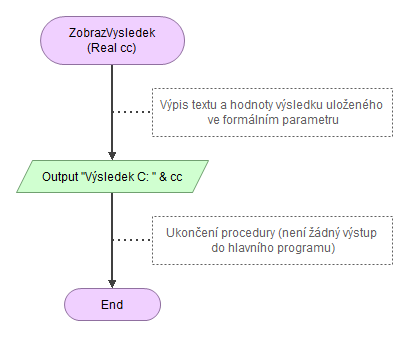
Asi si říkáte, že jsme sice pojistili program proti možným chybám ze strany uživatele ve formě vypsání varovné hlášky, např. možné dělení nulou, pokud uživatel zvolil aritmetickou operaci dělení a zadal druhé číslo 0. Sice se na první pohled může zdát, že ve funkci VydelParametry pouze stačí vypsat varovná hláška, ale pokud jste algoritmus spustili, asi jste byli zaskočeni, že aplikace Flowgorithm se zastavila u bloku mezní značky této funkce a bylo vypsáno varovné hlášení: Pokoušíte se číst data z proměnné, do které ještě žádná data nebyla vložena. Příčina: proměnná 'cc' nebyla inicializována (tj. naplněna počáteční hodnotou). Znamená to, že chceme předat jako výstup této funkce něco, co nám funkce ani nevypočítala (neproběhlo dělení parametrů) a proměnná 'cc' je ve skutečnosti prázdná - není v ní uložena žádná hodnota.
Pro ošetření těchto možných chyb a také k dalším účelům využijeme cykly.
1.10. Cyklus
Pokud je nějaká činnost pravidelně opakována, je vhodné použít bloky zachycující cyklus. V zásadě jde o dva typy cyklů – podmíněný (cyklus s podmínkou na začátku a na konci) a nepodmíněný (cyklus s krokem).
Cyklus s podmínkou na konci
Prvním příkladem podmíněného cyklu je cyklus s testem podmínky na konci, který nalezneme v aplikaci Flowgorithm pod značkou Do – viz Obrázek 1.
Obrázek 1: Značka cyklu s podmínkou na konci - bez větví
Proces uvnitř tohoto
cyklu je ukončen potom, co není splněna podmínka, tzn. větev False. Pokud nastane situace, že nedojde ke
splnění podmínky, proces uvnitř cyklu již není nadále prováděn a dochází k
opuštění cyklu ve směru větve True. U typu cyklu s podmínkou na
konci musí proces proběhnout minimálně jednou - viz Obrázek 2.
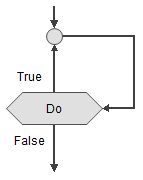
Obrázek 2: Značka cyklu s podmínkou na konci - obě větve
Algoritmus KalkulackaPodprogramyZadejKodOperace
- Popis: Vývojový diagram funkce pro zadání číselného kódu operace pomocí cyklu s podmínkou na konci
- Zadání: Na základě předchozího algoritmu KalkulackaPodprogramy zkuste navrhnout funkci ZadejKodOperace, která řeší zadání platného číselného kódu podle vypsaného číselníku kódů aritmetických operací pomocí cyklu s podmínkou na konci. Zadání číselného kódu bude probíhat neustále, dokud nebude definován validní (správný) číselný kód aritmetické operace (1 … sčítání, 2 … odečítání, 3 … násobení, 4 … dělení)
Cyklus s podmínkou na začátku
Dalším typem opakování je cyklus s podmínkou na začátku, kterou nalezneme v aplikaci Flowgorithm pod značkou While – viz Obrázek 3.
Obrázek 3: Značka cyklu s podmínkou na začátku - bez větví
Proces uvnitř tohoto cyklu je prováděn do té doby, dokud je splněna podmínka, tzn. větev True za rozhodovacím blokem - viz Obrázek 4.
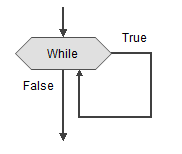
Obrázek 4: Značka cyklu s podmínkou na začátku - obě větve
Pokud nastane situace, že podmínka není splněna, smyčka cyklu již není nadále prováděna, tj. opuštění cyklu pomocí větve False. Je nutné podotknout, že proces uvnitř cyklu (uvnitř větve True) nemusí být proveden ani jednou, pokud nastane situace, že podmínka definovaná v cyklu, není při počátečním průchodu cyklem splněna.
Všimněte si, že princip opuštění tohoto cyklu je opačný než u předchozího
cyklus s testem podmínkou na konci.
Algoritmus KalkulackaPodprogramyVydelParametry
- Popis: Vývojový diagram funkce pro dělení zadaných čísel pomocí cyklu s podmínkou na začátku
- Zadání: Na základě předchozího algoritmu KalkulackaPodprogramy zkuste modifikovat funkci VydelParametry, která provádí aritmetickou operaci dělení dvou zadaných čísel, které jsou vstupními argumenty této funkce (formální parametry). Řešte tento problém pomocí cyklu s podmínkou na začátku. Uvnitř cyklu opakujte zadání hodnoty jmenovatele pomocí funkce ZadejCislo, dokud je jmenovatel nulový


Cyklus s krokem
Závěrečným typem tzv. nepodmíněného
cyklu je cyklus s krokem , kterou naleznete v aplikaci Flowgorithm pod značkou For – viz Obrázek 5.
Obrázek 5: Značka cyklu s krokem - bez větví
Z cyklu vycházejí dvě větve - Next a Done. Větev Next symbolizuje vnitřní smyčku cyklu, do níž budeme umísťovat jednotlivé značky, které budeme chtít opakovat. Větev Done symbolizuje ukončení cyklu - viz Obrázek 6.
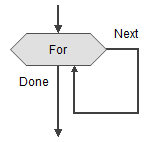
Obrázek 6: Značka cyklu s krokem - obě větve
Tento cyklus použijeme zejména tehdy, pokud víme, kolik proběhne smyček uvnitř cyklu, tedy je znám počet iterací. V průběhu těchto iterací je měněna hodnota tzv. čítače označovaného také jako řídící proměnná. Označme tuto řídící proměnnou písmenem i. U cyklu určujeme následující vlastnosti - viz Obrázek 7:
- Řídící proměnnou (čítač) - označme např. i
- Počáteční hodnota - dolní mez intervalu hodnot, kterých může nabývat čítač - označme např. a
- Konečná hodnota - horní mez intervalu hodnot, kterých může nabývat čítač - označme např. b
- Krok tzv. inkrement - hodnota přírůstku, nebo úbytku čítače v další smyčce
- Směr - hodnota řídící proměnné v každé smyčce cyklu buď roste (vzestupně) nebo klesá (sestupně) o specifikovaný krok
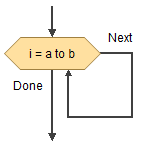
Obrázek 7: Značka cyklu s krokem - specifikace vlastností
Pojďme si vysvětlit princip postupně. Hodnota čítače je před provedením cyklu nastavena na specifikovanou počáteční hodnotu a. Po každém provedení smyčky přičte ke své aktuální hodnotě specifikovanou hodnotu kroku (inkrementu). Nejčastěji je hodnota kroku rovna jedné. Po proběhnutí specifikovaného počtu iterací, tedy že čítač překročil definovanou konečnou hodnotu b, je tento cyklus opuštěn a proces uvnitř cyklu již není nadále vykonáván. Každý proces uvnitř smyčky proběhne (b – a) + 1 – krát, pokud ve smyčce nedojde k násilnému ukončení probíhajícího cyklu.
Algoritmus KalkulackaPodprogramyZadejKodOperaceGrafika
- Popis: Vývojový diagram modifikované funkce pro zadání číselného kódu operace pomocí cyklu s krokem
- Zadání: Na základě předchozího algoritmu KalkulackaPodprogramy zkuste modifikovat funkci ZadejKodOperace. Do výpisu informujícího uživatele o možnostech zadání číselného kódu aritmetické operace vložte před výpis a za výpis textu (uloženého v proměnné vyzva) grafický prvek. Tento grafický prvek (uložený v proměnné grafika) představuje znaky hvězdiček, tj. "*" umístěné v řádce za sebou. Jejich počet je roven délce počtu znaků textu výzvy (uložené v proměnné delkaVyzvy). Jednotlivé grafické prvky oddělte od výpisu výzvy novým řádkem (nová řádka, tj. ToChar(10) - znak v ASCII)
Řešení:
1.11. Sestavení programu v návaznosti na algoritmus
Předpokládejme, že jsme již problém formulovali a vytvořili potřebný algoritmus, nebo algoritmy řešící daný problém. Jako další fáze je tzv. kódování, tzn. sestavení programu ve vybraném programovacím jazyce, abychom mohli ve finále obdržet efektivně fungující aplikaci – viz Obrázek 1.
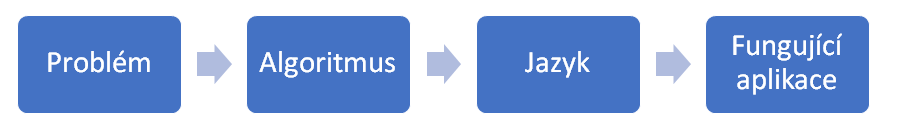
Obrázek 1: Kroky při vytváření aplikace
Kódováním programu se rozumí zápis algoritmu ve vhodném programovacím jazyku. Volba programovacího jazyka je velmi důležitá. Některé programovací jazyky jsou univerzální, jiné jsou vhodné jen pro určitý typ úloh. Vysvětleme si, co znamená programovací jazyk.
Programovací jazyky – obecně
Podstatná většina lidí běžně používá k dorozumívání jazyk. Pokud se nad tímto pojmem zamyslíme, jazyk je souhrn symbolů a pravidel, který podává návod, jak spojovat a obměňovat různé symboly. Jsou v něm stanovena jistá pravidla, která dávají význam jednotlivým symbolům a jejich spojením. Stejné principy jsou použity i u programovacích jazyků. Programovací jazyk (anglicky „Programming Language”) je umělý jazyk, vytvořený pro komunikaci mezi člověkem a počítačem, který slouží k zápisu algoritmů. V tomto umělém jazyce je využíván souhrn jednoznačných pravidel, kterými se řídí formální zápis programu – Syntaxe (anglicky „Syntax“). Sémantika (anglicky „Semantics“) jednoznačně určuje význam programu. Znalost sémantiky programovacího jazyka umožňuje zapsat program tak, že odpovídá požadovanému algoritmu.
V dnešní době existuje velké množství programovacích jazyků, které se liší uživatelskou přívětivostí, bezpečností v programování, tvorbou efektivního kódu i oblastí nasazení. Řada pojmů je však v různých jazycích společná nebo blízká. Znalost jednoho jazyka, stejně jako v případě živých jazyků, ulehčuje studium jiného jazyka.
Programovací jazyk je možné popsat pomocí metajazyků. Metajazyk (anglicky „Meta Language“) je jazyk pro popis jazyka. Metajazyky jsou úspornější a přesnější než popis např. pomocí přirozeného jazyka. Precisní popis jazyka bez nejednoznačností je předpokladem pro úspěšnou tvorbu překladače a správné fungování programů v tomto jazyce vytvořených.
Vývoj programovacích jazyků
Pojďme si něco říci k vývoji programovacích jazyků. Jazyky lze dělit do určitých generací:
1. generace jazyků - Strojově orientované jazyky
Strojově orientované jazyky, nebo také strojový kód - jsou nejnižší programovací jazyky, kde jednotlivé instrukce jsou přeloženy do binární podoby a ty jsou zpracovány mikroprocesorem („Central Processing Unit“ - CPU). Mikroprocesor dokáže vykonat omezené množství elementárních instrukcí (např. modifikaci adres, přičtení, odečtení, vynásobení, vydělení, skoky mezi instrukcemi) uložených jako sekvence bitů obvykle zadaných v hexadecimální (šestnáctkové) soustavě, představujících čísla. Nelze tedy jednoduše sečíst dvě čísla, ale je to proces více instrukcí odkazující se na místa (adresy) v paměti, se kterými pracuje. Tyto kódy jsou velmi obtížně čitelné až skoro nečitelné
2. generace - Strojové jazyky
Strojové jazyky nebo jejich symbolické verze jsou tzv. jazyky symbolických adres nebo asemblery (zkráceně ASM - anglicky „Assembler“). Instrukce mají slovní označení (kód) a odpovídají jedné operaci procesoru. Kódy takových instrukcí se přeloží do strojového kódu a jsou následně zpracovány mikroprocesorem. Programy se v nich vytvářejí dlouho, ale takto vytvořené programy pracují velmi rychle. Programy v nich jsou nestrukturovány a jsou proto špatně srozumitelné člověku.
Zobrazení instrukcí je dáno konstrukcí počítače. Liší se tedy podle typu počítače. Je třeba znát základní princip, rozdělení na operační kód a adresní část instrukce. Program popisuje algoritmus (předpis) zpracování údajů. Je tvořen posloupností instrukcí (u vyšších program. jazyků příkazů). Instrukce je elementární příkaz, který je z pohledu programátora chápán jako dále nedělitelný krok programu. Instrukce je podobně jako data uložena v paměti počítače, kde zabírá určité paměťové místo. Velikost zabraného paměťového místa se nazývá délka instrukce. Instrukce má většinou několik částí (viz Obrázek 2), z nichž některé mohou – podle druhu instrukčního kódu nebo vlastní funkce instrukce – chybět:
- Kód operace (vždy) - jednoznačně specifikuje operaci, která se bude podle dané instrukce provádět. Množina všech instrukcí tvoří tzv. operační kód počítače. Kód instrukce se v assembleru označuje jménem
- Adresní část (může být někdy vynechána) - obsahuje adresy operandů, se kterými se bude provádět operace určená kódem operace např. ADD X, Y ... instrukce pro součet dvou operandů. Adresní část může být jedno, dvou nebo tříadresová podle toho, kde jsou příslušné operace prováděny (střádače, případně další registry). U některých instrukcí může adresní část chybět nebo mohou údaje, uvedené na místě adresy znamenat něco jiného (např. celočíselnou konstantu). Skutečná adresa vzniká sečtením adresní části z instrukce s tzv. indexregistry (jedním nebo více)
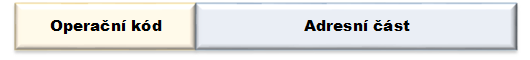
Obrázek 2: Zobrazení instrukce
Množina všech instrukcí počítače na nejnižší úrovni se nazývá strojový kód počítače. U vyšších programovacích jazyků se algoritmus popisuje pomocí příkazů, které později překladač (kompilátor) rozloží (kompiluje) do jednotlivých instrukcí, které pak mohou být počítačem provedeny.
Pozn.: Pro ladění se obvykle užívají prohlížeče kódu, které zobrazují instrukce symbolickými jmény.
Jak se pomocí jednoadresových instrukcí zapíše příkaz X = Y + Z?
Použije se speciální buňka v paměti zvaná
střádač (akumulátor) a příkaz se rozdělí na tři instrukce:
- LDA Y ... naplň Y do střádače
- ADD Z ... přičti Z do střádače
- STA X ... ulož střádač do X
3. generace - Vyšší programovací jazyky
Pro ně je charakteristické zavedení operačních, řídících a datových struktur, které zvyšují srozumitelnost a čitelnost vytvořeného programu. Mezi tyto programovací lze zahrnout: Pascal, Fortran, Cobol, Ada, C, Basic, Java atd.
Jazyky 3. generace lze v zásadě rozdělit na 3 kategorie:
- Kompilované jazyky
- Interpretované jazyky
- Jazyk s virtuálním strojem
Kompilované jazyky
Mezi kompilované jazyky patří např. Pascal, Delphi, C, C++ - Program musí být zapsán v programovacím jazyce a uložen do paměti počítače. Této formě programu vytvořené programátorem se říká zdrojový program nebo zdrojový kód (anglicky „Source Code“). Zdrojový kód je pomocí překladače – kompilátoru (anglicky „Compiler“) přeložen do tvaru bližšímu počítači, tj. do strojového kódu, který je spuštěn na mikroprocesoru - viz Obrázek 3.
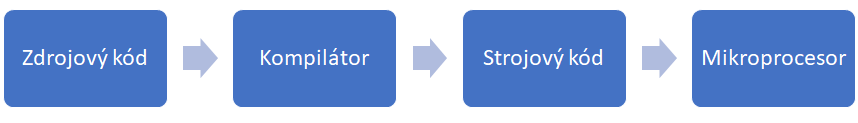
Program je v tzv. jazyce relativních adres. Během překladu překladač kontroluje syntaktickou správnost programu a při nalezení chyby překlad přeruší a vrátí řízení do editoru programovacího jazyka, který překládaný program zobrazí a promítne do něj na příslušné místo zprávu o nalezené chybě. Programátor musí chybu opravit a znovu spustit překlad. Tento cyklus se opakuje tak dlouho, dokud je v programu nějaká formální (syntaktická) chyba.
Bez chyby přeložený program obsahuje vždy minimálně několik symbolů, které překladač nezná. Mohou to být buď jména proměnných, které programátor zapomněl deklarovat nebo jména standardních podprogramů. Sestavovací program (anglicky „Linker“) předpokládá, že tyto objekty jsou v některé knihovně. Proto knihovny prohledá a nalezne-li podprogram, jehož jméno je shodné s hledaným symbolem, přisestaví ji k programu (po příslušných kontrolách typu). Knihoven je větší počet. Některé jsou prohledávány vždy, některé jen na zvláštní přání uživatele. Nenalezne-li se hledaný symbol v žádné knihovně, jde o zmíněnou deklarační chybu a celý překlad je s příslušným hlášením ukončen.
Na
konci tohoto procesu existuje přeložený, tzv. spustitelný program
uložený v počítači (lze jej spustit příslušným příkazem operačního
systému). Výsledkem sestavení může být i tzv. mapa, která obsahuje adresy
podprogramů a některých proměnných. Pro ladění programu se používají ladící
nástroje (anglicky „Debugger“), které umožňují např. program krokovat po jednotlivých
příkazech, prohlížet a měnit hodnoty proměnných. Celý proces od vytvoření
zdrojového programu programátorem až po uložení spustitelného programu bývá
výrobci softwaru zajištěn dodávkou tzv. programovacího prostředí.
Mezi
výhody kompilovaného jazyka patří: rychlost kompilovaného programu, jednodušší
odladění – hledání chyb ve zdrojovém kódu, nemožnost jednoduché modifikace
kompilovaného kódu bez zdrojového kódu.
Mezi nevýhody kompilovaného
jazyka patří: program je závislý na operačním systému a procesoru,
nelze přenést na jinou platformu, kompilovaný strojový kód nelze editovat,
možné přetečení paměti díky absenci automatické správy paměti.
Interpretované jazyky
Mezi interpretované jazyky patří např. PHP. Programy psané v interpretovaném jazyce lze přenášet
na různé platformy (hardware – procesor, paměti, připojené periferie i software
– operační systém, knihovny, framework, programovací jazyk). Interpret, na
rozdíl od kompilátoru, nepřekládá celý program najednou, ale pouze to, co je při
běhu programu v danou chvíli zapotřebí. Překládá (kompiluje) tedy každý
řádek kódu do strojového kódu a ten vykoná. Po vykonání příkazu výsledek
kompilace zahodí a přechází na nový řádek. Daní tohoto přístupu je vyšší
zatížení procesoru - viz Obrázek 4.
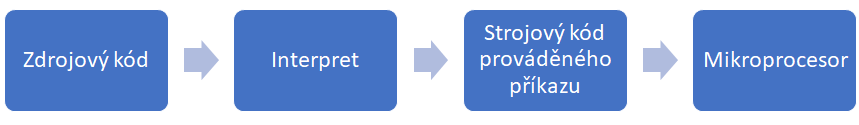
Obrázek 4: Interpretované jazyky
Mezi výhody interpretovaného jazyka patří: přenositelnost, pokud existuje interpret pro platformu, použití automatické správy paměti (anglicky „Garbage Collector“), shodné datové typy, kolekce atd., stabilní běh kompilovaného programu (reflexe – kontrola běhu programu), možnost editace programu za běhu programu.
Mezi nevýhody kompilovaného jazyka patří: odhalení chyby v kódu (chyba odhalena, pokud je spuštěn), pomalý běh programu díky interpretaci, možnost napadení zdrojového kódu (program se šíří ve zdrojovém kódu)
Jazyk s virtuálním strojem
Do jazyků s virtuálním strojem patří např. C#, Java. Tyto jazyky jsou spojením výhod kompilovaného a interpretovaného jazyku. U jazyka C# se zdrojový kód programu nepřeloží do strojového kódu počítače, ale do mezikódu – univerzálního pomocného jazyku označovaného „Common Intermediate Language“ – „CIL“ (má jednodušší instrukční sadu a podporuje objektové programování). Ten se pomocí dalšího interpreteru - u .NET je to „Common Language Runtime“ – „CLR“ - převede do strojového kódu cílového počítače, ale zpravidla až v okamžiku, kdy program spustíme. Virtuální stroj již převedený kód nezahazuje jako u interpretovaných jazyků - viz Obrázek 5.
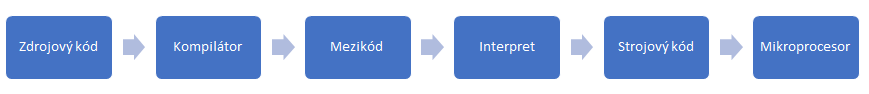
Obrázek 5: Interpretované jazyky
s virtuálním strojem
To znamená, že na cílovém počítači musí být překladač, který překládá z „CIL“ do strojového kódu. Tento počítač se nazývá je z anglického „Just In Time“ – „JIT“, neboť překládá právě v době, kdy je potřeba). Věc je ale složitější: Na cílovém počítači musí být instalován tzv. virtuální stroj – prostředí „.NET Framework“, které kromě překladačů JIT obsahuje i další součásti potřebné pro běh programů vytvořených v jazyce C#.
Na závěr ještě doplníme, že překladač libovolného programovacího jazyka (i C#) zároveň kontroluje syntaktickou správnost programu, tedy zda je program napsán podle jistých formálních pravidel, která zaručují, že mu počítač rozumí. Syntaktická správnost programu bohužel nezaručuje věcnou správnost programu, tj. nezaručuje, že program bude dělat to, co si přejeme. [3]
Doplňme ještě další výhody, kterými jsou: stabilita provádění kódu, správa paměti, shodné datové typy, přenositelnost kódu mezi programovacími jazyky (C#, Visual Basic, C++), pomalejší start ale vyšší rychlost provádění operací než interpretovaný jazyk (menší než kompilovaný jazyk), malá možnost napadení kódu (špatná čitelnost zdrojového kódu v „CIL“)
Jazyky 4GL a jazyky usnadňující programování
Jsou
specializované na určitou oblast, vyskytují se například při zpracování dat v
databázových systémech. Zahrnují v sobě prostředky pro generaci menu, masek obrazovek,
výstupních sestav apod. Příkazy těchto jazyků vykazují značnou vyjadřovací
sílu. Vývoj aplikací pak probíhá rychleji než u jazyků tzv. 3 generace.
Aplikace ale pracují obvykle pomaleji.
1.12. Odladění a ověření programu
Co produkuje výsledky, nemusí být správné, je třeba proto provést test na vhodné množině zkušebních dat. Stanovení vhodné množiny dat nemusí být jednoduché. Je třeba testovat obvyklá data, data mimo meze platnosti, hraniční data i náhodná data. Testy je třeba plánovat a dokumentovat. V případě oprav v programech je vhodné testy zopakovat se stejnými data. U složitějších programů je exaktní testování problematické.
Musíme si především uvědomit, že testováním můžeme nalézt chyby a pak je následně eventuálně opravit. V tomto případě se uvádí paradoxní věta o úplné indukci v programování:
„V každém dostatečně velkém programu se vždy vyskytuje alespoň jedna chyba.“
To
můžeme vidět v praxi na vývoji operačních systémů, standardních programů i
uživatelsky zaměřených programů (např. informační systémy řízení výroby). Jak
tedy postupovat? Je třeba přijmout určitá konstruktivní opatření pří
tvorbě algoritmů a programového kódu. Mezi tato konstruktivní opatření patří
různé směrnice, jak psát programy, doporučené a nedoporučené programové
konstrukce a metody dekompozice. V etapě testování potom jde o výběr
vhodných metod testování a vhodných testovacích dat, personální oddělení
kódovačů a ladičů, dvojí nezávislé kódování atd.
Metody testování programů lze rozdělit na dvě základní skupiny:
- Funkční testy (černá schránka) - při testování se nezkoumá kód programu, nýbrž reakce programu na testovací data
- Strukturní testy (bílá schránka) - při testování je znám kód programu a pomocí vhodných dat se prověřuje funkčnost jednotlivých jeho částí
Obrázek 1: Funguje to správně?
Skutečně spolehlivé
programy, jako jsou bankovní transakce, řízení zdravotnických přístrojů pro
zajištění životních funkcí pacienta, řízení zbraňových systémů a jaderných
elektráren vyžadují důmyslné konstruktivní opatření a testování. Takové
programy jsou nesmírně drahé a programátorská produktivita je nízká.