Základní pojmy
| Site: | Moodle ZČU |
| Course: | KPV/TI Technická informatika ve strojírenství - šablona |
| Book: | Základní pojmy |
| Printed by: | Nepřihlášený host |
| Date: | Sunday, 8 November 2026, 4:33 PM |
Description
Při programování je třeba si uvědomit, že různé datové typy mají také různé rozsahy hodnot, tzn. různé dolní a horní meze. Při překročení rozsahu během aritmetických výpočtů mohou nastat různé problémy. Uvidíme, že reálná čísla jsou ukládána jen přibližně, což může mít vliv zejména na přesnost opakovaných výpočtů.
1. Zobrazení údajů v počítači
Do počítače je nutné vložit údaje, které se mají zpracovat (v počítači se údajům říká data). Zpracování probíhá velkou rychlostí, mnohonásobně převyšující schopnosti člověka. Údaje vkládané do počítače je nutné převést do formy srozumitelné počítači, tj. údaje se tzv. kódují (anglicky „Coding“). Kódování je tedy předpis, jak k sobě přiřadit prvky dvou množin. Číslicový počítač jako stroj pracuje s tzv. binární abecedou (anglicky „Binary Code“) tj. abecedou obsahující jen 0 a 1 (dvouhodnotová abeceda). V praxi to znamená, že např. můžeme převést pomocí algoritmu (postupu) číslo z desítkové soustavy např. (65)10 do dvojkové soustavy (01000001)2, aniž by se tato hodnota změnila. Asi si říkáte, jak tomu mohu věřit, vždyť ani nevím, kolik těch jedniček, nebo nul je zapotřebí. Abychom si mohli vysvětlit algoritmus převodu, nejprve si potřebujeme osvětlit některé základní pojmy:
-
Bit (zkratka z anglického „Binary Digit“, vyslov bit) je nejmenší množství informace, kterému počítač rozumí a rozlišuje je. V textu se zkracuje na „b“ (např. přenesené množství dat v síti je 10Mb, tzn. deset megabitů). Bit má hodnotu 1 nebo 0, tzn., že jedna pozice v řetězci zapsaném ve dvojkové soustavě, může nabývat hodnoty 0 nebo 1
-
Byte (vyslov bajt - slabika) vyjadřuje počet 8 bitů, tzn. osm pozic v řetězci zapsaném ve dvojkové soustavě, kde každá pozice může nabývat hodnoty 0 nebo 1. Používá se často k zakódování jednoho znaku běžné abecedy, např. písmeno „A“ má v ASCII kódu (kódová tabulka pro znaky – bude dále v textu vysvětleno) přidělenu dvojkovou kombinaci (01000001)2, čemuž v desítkové soustavě odpovídá číslo (65)10. V textu se zkracuje na „B“ (např. 64MB může znamenat šedesát čtyři milionů bajtů operační paměti počítače). Počet kombinací nul a jedniček na osmi bitech jednoho bajtu je 28 = 256, to znamená, že do jednoho bajtu by bylo možno zakódovat 256 různých znaků. Byte může obsahovat i velmi krátké celé číslo se znaménkem nebo bez něj.
-
Slovo (anglicky „Word Size“ ) vyjadřuje velikost dat, která mohou být přenesena do nebo z paměti v rámci jedné operace (většinou zabírá 2B nebo 4B v paměti)
-
Data jsou číselné, alfanumerické nebo logické údaje, uložené v paměti počítače a určené ke zpracování na počítači. Pojďme si předvést jednoduchý případ ukázky dat, např. hodnota 24. U této hodnoty nevíme, co může znamenat
-
Informace jsou data interpretovaná v definovaných souvislostech, např. co kdybychom ale dále dodali informaci 24 °C, nebo 24 dní, nebo 24 krasavic, atd.
-
Znalosti vyjadřují vztahy a trendy získané z dlouhodobých datových řad
2. Převody čísel do různých soustav
V soustavách se užívají různé číslice, nebo písmena:
- Ve dvojkové soustavě je základ soustavy 2 a používají se číslice 0 a 1
- V osmičkové soustavě je základ 8 a používají se číslice 0, 1, 2, 3, 4, 5, 6 a 7
- V desítkové soustavě je základ 10 a používají se číslice 0, 1, 2, 3, 4, 5, 6, 7, 8 a 9
- V šestnáctkové soustavě je základ 16 a používají se číslice 0, 1, 2, 3, 4, 5, 6, 7, 8, 9 a písmena, která vyjadřují zbytek větší než 9, tzn., A (pro číslo 10), B(11), C(12), D(13), E(14) a F(15)
Rozsah zobrazitelných čísel celých čísel při uložení ve dvou bytech je -215 až 215 – 1, tj.-32 768 až +32 767. Měli bychom podotknout, že intervalu náleží i 0, proto horní mez intervalu je rovna absolutní hodnotě meze dolního intervalu sníženého o 1.
Pozn.: Pro násobky se používají předpony k (kilo = 1024), M (mega = 1024x1024), G (giga = 1024x1024x1024). Tyto předpony se mírně liší od předpon používaných v matematice a fyzice. Vychází se z praktické potřeby práce ve dvojkové soustavě, neboť 1024 = 210 .
Algoritmus BinarniPrevodPodprogramValidace
- Popis: Vývojový diagram převodu čísla z desítkové do dvojkové soustavy zobrazené v 1 Bytu
- Zadání: Zkuste vymyslet algoritmus, který převede číslo z intervalu 0 až 255 zadané v desítkové soustavě do dvojkové soustavy
- Řešení:
Podstata příkladu převodu čísla zapsaného v desítkové soustavě a následným převodem do binární (dvojkové) soustavy tkví v celočíselném dělení hodnotou 2 a sledování zbytku po dělení v každé iteraci. V algoritmu má dojít k Validaci zadané hodnoty, tj. zda hodnota vyhovuje definovaným podmínkám – musí se pohybovat v rozmezí dolní meze intervalu (tj. 0) a horní meze intervalu (tj. 255). Proč jsme zvolili právě tyto meze? Protože minimální hodnota, kterou lze uložit do 1 B je 0. Jak víte, 1 B představuje 8 bitů. Na každé pozici čísla ve dvojkové soustavě může být buď 0, nebo 1. Pokud bychom tedy napsali na všechny pozice 0, bude toto číslo představovat v desítkové soustavě 0. Pokud bychom všude zapsali 1, představuje těchto osm jedniček hodnotu 255 v desítkové soustavě. Zvídavým lidem napovím, že podmínka horní meze je definována záměrně, aby nedošlo k přetečení 1 B (jednoho Byte). Tuto podstatu vysvětlíme při zpětném přepočtu čísla ve dvojkové soustavě zpět do desítkové soustavy.
Pro podprogram Validace je deklarována proměnná:
n – tato proměnná představuje validní hodnotu v desítkové soustavě zadanou uživatelem jako vstup
V podprogramu (funkci) Validace se nachází cyklus s podmínkou na konci, který testuje, zda zadaná hodnota splňuje podmínky. U cyklu je patrné, že cyklus zadávání vstupní hodnoty bude opuštěn pouze tehdy, pokud podmínka není splněna. Proto jsme tuto podmínku museli formulovat jako (n < 0) || (n > 255). To znamená, že pokud hodnota bude menší než 0, nebo bude větší než 255, podmínka cyklu bude splněna a zadávání vstupní hodnoty proběhne znovu. Pokud tato podmínka není splněna, opustí se cyklus a dojde k vykonání dalšímu kroku podprocesu. Tento krok představuje přiřazení proměnné n do výstupu podprogramu - funkce. Znamená to, že hodnota uložená v n bude předána zpět do algoritmu nazvaného BinarniPrevod, ze kterého byla vyvolána (spuštěna).
V deklaraci lokálních proměnných hlavního programu (Main), platných pouze pro algoritmus BinarniPrevod, jsou uvedeny dvě proměnné:
decimalniHodnota - představující hodnotu zadaného čísla v desítkové soustavě načtené ve funkci Validace, kde výstupní hodnota z této funkce byla přiřazena do této proměnné pomocí výrazu decimalniHodnota = Validace()
binarniText - představující textový řetězec (datový typ String) konvertovaného čísla z desítkové soustavy do dvojkové
Na začátku algoritmu binárního převodu je provedeno zavolání podprogramu – v našem případu funkce Validace (bez jakýchkoliv vstupních parametrů – proto prázdná závorka ve výrazu), která nám vrátí validní hodnotu zadaného čísla od 0 do 255. Obsah proměnné binarniText je před postupným plněním vymazán pomocí přiřazení prázdného řetězce (mezi dvojitými uvozovkami není žádný text). Konverze čísla je prováděna pomocí cyklu s podmínkou na začátku. Tato podmínka je vykonávána do té doby, dokud platí, že hodnota uložená v proměnné decimalniHodnota je větší než nula, tj. decimalniHodnota > 0 (stále existuje zbytek, kterým lze celočíselně dělit a zjišťovat zbytek po celočíselném dělení). Prvním krokem provedeným v rámci každé iterace cyklu je provedení celočíselného dělení číslem 2 (je to dvojková soustava – existují pouze dvě číslice 0 nebo 1). Pokud je tento zbytek roven 0, tj. podmínka decimalniHodnota % 2 == 0, pak do textu v proměnné binarniText potřebujeme zleva připojit text “0“ (do datového typu String, čili text, můžeme vkládat pouze text, proto použití uvozovek). Pokud tomu tak není, tzn., že zbytek po celočíselném dělení je 1, připojíme do proměnné binarniText zleva text “1“. V dalším kroku provedeme celočíselné dělení číslem 2. Všimněme si, že tuto novou hodnotu získanou z vyhodnocení pravé strany od rovnítka, přepíšeme dosavadní hodnotu uloženou v proměnné decimalniHodnota. Co ta znamená? Nic zásadního, pokud nepotřebujeme vypsat počáteční validní hodnotu obdrženou z funkce, kterou jsme uložili do proměnné decimalniHodnota. Tím že postupně přepisujeme tuto hodnotu, si ušetříme místo v paměti, protože nepotřebujeme deklarovat další proměnnou, která by zabírala místo v paměti. Po opuštění cyklu je uživateli vypsán text “Číslo ve dvojkové soustavě:“ a za ním je vypsána hodnota konvertovaného čísla do dvojkové soustavy. Pro spojení dvou textů (konkatenace) dohromady jsme využili operátoru &.
Algoritmus DecimalniPrevodPodprogramValidace
- Popis: Vývojový diagram převodu čísla ze dvojkové soustavy na 1 B zpět do desítkové soustavy
- Zadání: Zkuste vymyslet algoritmus, který převede binární hodnotu (8 bitů ve dvojkové soustavě) na číslo v desítkové soustavě. Po načtení binární hodnoty proveďte validaci zadané hodnoty – hodnota musí být na 8 bitech a nesmí obsahovat jiný než 0 nebo 1
- Řešení:
Pro podprogram Validace, jenž je funkce s výstupem ve formě celého čísla (datový typ Integer), jsou deklarovány následující proměnné:
- binarniHodnota – tato celočíselná binární hodnota (datový typ int) zadaná na 1 Byte, čili 8 bitech (každý bit může obsahovat 1 nebo 0) je konvertována do decimální (desítkové) soustavy
- binarniHodnotaPom – pomocná proměnná, která nám bude sloužit pro provedení testů validace
- posledniCislice – proměnná pro uložení zbytku po celočíselném dělení binární hodnoty hodnotou 10
- pocetChybnychBitu –počet zjištěných chybných pozic (bitů) v zadané celočíselné binární hodnotě
- pocetPlatnychBitu – počet zjištěných platných pozic (bitů) v zadané celočíselné binární hodnotě
- celkovyPocetBitu – celkový počet zadaných bitů
- chyba – informace (Booleanovská proměnná) zda v zadané binární hodnotě byla nalezena chyba (buď ve formě celkové počtu zadaných bitů, nebo jiné než možné hodnoty uložené v bitu). Možná hodnota uložená v této proměnné datového typu bool je hodnota True (zjištěna chyba v zadané binární hodnotě) nebo False (zjištěna chyba v binární hodnotě)
Na začátku funkce Validace je uživatel vyzván, aby zadal binární hodnotu maximálně ve velikosti 8 bitů, což představuje 1 Byte. Po načtení a uložení této hodnoty do proměnné binarniHodnota je tato hodnota překopírována do pomocné proměnné, kterou postupně budeme testovat. Je také nutné inicializovat proměnné pocetChybnychBitu, pocetPlatnychBitu a celkovyPocetBitu na počáteční hodnotu 0. Cyklus testuje sestupně platnost bitů od nejvyšší pozice s desítkovým základem. Pokud nejvyšší pozice obsahuje jedničku, představuje desítky miliónů, tj. 1*107 (osmá pozice bitu zprava). Nejvyšší číslo, co může uživatel v binární podobě zadat, je tedy 11111111. V první iteraci jsou testovány desítky miliónů a v poslední iteraci jsou testovány jedničky (pokud na první pozici binární hodnoty zprava je umístěna 1, pak tato hodnota představuje číslo 1*100 = 1). Za účelem testování této pozice využijeme operaci zbytku po celočíselném dělení – operátor %. Spočtenou hodnotu zbytku po celočíselném dělení si uložíme do proměnné posledniCislice. Pokud tato číslice neobsahuje 0 nebo 1, je provedena inkrementace počtu chybných pozic (zvýšení aktuální hodnoty o 1). Tato hodnota je uložena do proměnné pocetChybnychBitu. Pokud nebyla zjištěna chyba na aktuální pozici (v první iteraci je to první pozice v binární hodnotě zprava), je zvýšen aktuální počet platných pozic o 1. Tato hodnota je uložena do proměnné pocetPlatnychBitu. Po ukončení rozhodovacího bloku je provedeno celočíselné dělení desítkou, proto abychom se posunuli na další pozici vlevo od aktuální pozice (ve druhé iteraci budeme testovat desítky). Po provedení všech iterací se dostaneme v pomocné proměnné binarniHodnotaPom na hodnotu 0 (při každé iteraci jsme snižovali o desítkový řád), tzn., cyklus testování platnosti bitů je ukončen a přecházíme k dalšímu procesu, který spočte celkový počet bitů. Tento celkový počet představuje sečtení zjištěného počtu chybných a platných bitů. Tento počet využijeme při dalším testování. Pokud je počet chybných bitů větší než 0, nebo celkový počet bitů je větší než 8, tak se ve vývojovém diagramu vydáme za rozhodovacím blokem větví True, tj., byla splněna alespoň jedna z definovaných podmínek chyby. Další následná rozhodovací podmínka v této větvi testuje, zda byl překročen počet povolených bitů. Pokud ano, je uživateli vypsáno varování: Validace počtu bitů: neúspěšná - celkový počet bitů: a za tento text je umístěna hodnota celkového počtu bitů. Pokud byl dodržen celkový počet bitů, vydáme se v algoritmu větví False. Dalším prováděným testem po předchozím testu je test na počet chybných bitů v binární hodnotě. Pokud byl zjištěn nějaký chybný bit, je uživateli zobrazeno hlášení o neúspěšné validaci včetně vypsání zjištěného počtu neplatných bitů. Vzhledem k tomu, že bylo zjištěno alespoň jedno pochybení, ať už ve formě překročení celkového počtu bitů, nebo neplatné hodnoty bitu, musíme uložit tuto informaci do proměnné chyba. Tato Booleanovská proměnná může nabývat hodnoty True, tj., byla zjištěna chyba v zadané binární hodnotě, nebo False (nebyla zjištěna chyba – ve vývojovém diagramu jsme v záporné větvi za testem (pocetChybnychBitu > 0) || (celkovyPocetBitu > 8). Celý proces zadávání binární hodnoty je opakován, dokud byla nalezena nějaká chyba v binární hodnotě – cyklus s podmínkou (chyba == True) na konci. Po správném zadání binární hodnoty je platná hodnota předána zpět do algoritmu DecimalniPrevod, ze kterého byla funkce zavolána.
Pro algoritmus DecimalniPrevod jsou deklarovány následující proměnné:
- binarniHodnota – do této proměnné je uložena celočíselná hodnota vrácená z funkce Validace. Tato hodnota je následně konvertována do desítkové soustavy
- decimalniHodnota – do této proměnné je uložena celočíselná výsledná hodnota v desítkové soustavě
- posledniCislice – do této proměnné je postupně ukládán koeficient (1 nebo 0), kterým je násoben základem binární soustavy uložené v proměnné zaklad
- zaklad – základ binární soustavy (tj. 2x, kde x představuje index od 0 až 7 v případě osmi bitů. Pro první bit zprava u binární hodnoty je základ 20 = 1, pro druhý zprava je základ 21=2, pro třetí 22=4, atd.)
Na začátku algoritmu je provedeno uložení binární hodnoty získané z funkce Validace do proměnné binarniHodnota. Následuje nastavení počáteční hodnoty u proměnné decimalniHodnota na hodnotu 0 a základu binární soustavy na hodnotu 1 (v první iteraci je základ 20 = 1). Po provedení inicializace je prováděn cyklus s podmínkou na začátku představující postupné plnění proměnné decimalniHodnota postupným násobením bitů z binárního čísla základem dvojkové soustavy. Prvním krokem prováděným v tomto cyklu je zjištění poslední číslice, tzn., číslice zprava z binárního čísla, tedy 0 nebo 1. Pro zjištění číslice využijeme operaci zbytku po celočíselném dělení hodnotou 10. Zjištěnou hodnotu si uložíme do proměnné posledniCislice. Následný proces celočíselného dělení hodnotu 10, je prováděn proto, abychom oddělili první bit zprava v binární hodnotě. Tím se nám binární hodnota zmenší. Decimální hodnotu čísla pro daný bit spočteme tak, že k aktuální hodnotě decimálního čísla (před první iterací je tato hodnota 0 – hodnota nastavena před vstupem do cyklu) přičteme hodnotu poslední číslice zprava v binární hodnotě násobenou základem. V první iteraci je tento základ 1, protože 20 = 1. Po uložení vypočtené decimální hodnoty musíme změnit základ. Tento základ dvojkové soustavy se v každé iteraci mění. Pro první iteraci byl 20 = 1, pro druhou iteraci je 21 = 2, pro třetí 22 = 4, atd. Uvědomme si, že 22 lze rozepsat jako 22 = 2 * 2 = 4. Proto základ můžeme rozepsat pomocí výrazu zaklad = zaklad * 2, který popisuje princip postupného násobení základu dvojkou (první iterace je 20 = 1, další je 1*2, další je 1*2*2, atd.).
Jakmile proběhnou všechny iterace nutné k výpočtu
výsledné decimální hodnoty, je tento výsledek zobrazen uživateli včetně
popisku, že se jedná o konvertované číslo.
3. Kódování jednotlivých znaků
Obvykle 1 údaj (znak) zabere
1 byte paměti. Existují různé způsoby kódování, tj. způsoby zobrazení znaků v
počítači. V praxi se ustálilo použití pouze několika systémů kódování, z nichž
nejpoužívanější je: ASCII kód.
ASCII -zkratka American Standard Code for Information Interchange – znamená americký standardní kód pro výměnu informací. V podstatě jde o kódovou tabulku, která definuje znaky anglické abecedy a jiné znaky používané v informatice. ASCII kód byl vytvořen v roce 1963 a obsahoval pouze velká písmena a čísla. V roce 1967 byla přidána malá písmena a znaky na 7 bitech (hodnota 0 -127 odpovídá pozici znaku) - viz norma ISO 6429 (kód se také označuje ISO-7).
Nevýhodou ASCII kódu je, že kód definuje pouze znaky anglické abecedy a nedokáže obsáhnout znaky národních abeced. Rozšířením na 8 bitů se získá kód, který se používá jako vnitřní kód (umožňuje použít specifické znaky pro daný jazyk – většinou s diakritikou). Asi tabulku nevědomky běžně využíváte, když stlačíte klávesu ALT +zadáte číselný kód (např. Alt + 64 vám na české klávesnici vypíše znak na pozici 64, tj. „@“).
Kód definuje celkem 256 znaků s hodnotou 0 ÷ 255, kde znaky v rozsahu:
- 0 ÷ 31 jsou tzv. řídící znaky
- 32 ÷ 126 zobrazitelné znaky
- 127 e definován normou jako řídící znak DEL - viz Tabulka 1.
- 128 ÷ 255 jako speciální znaky. Speciální znaky definující řadu semigrafických znaků a znaky národních abeced. Podle toho pak existují národní modifikace ASCII kódu, např. kód IBM PC-Latin 2 (ČSN 9103/89), ISO Latin 2 (ISO 8859-2), který obsahuje české znaky s diakritikou, např. č, ř, á, ě apod. Ve střední Evropě se pro kódování používá sada ISO 1250 - viz Tabulka 2.
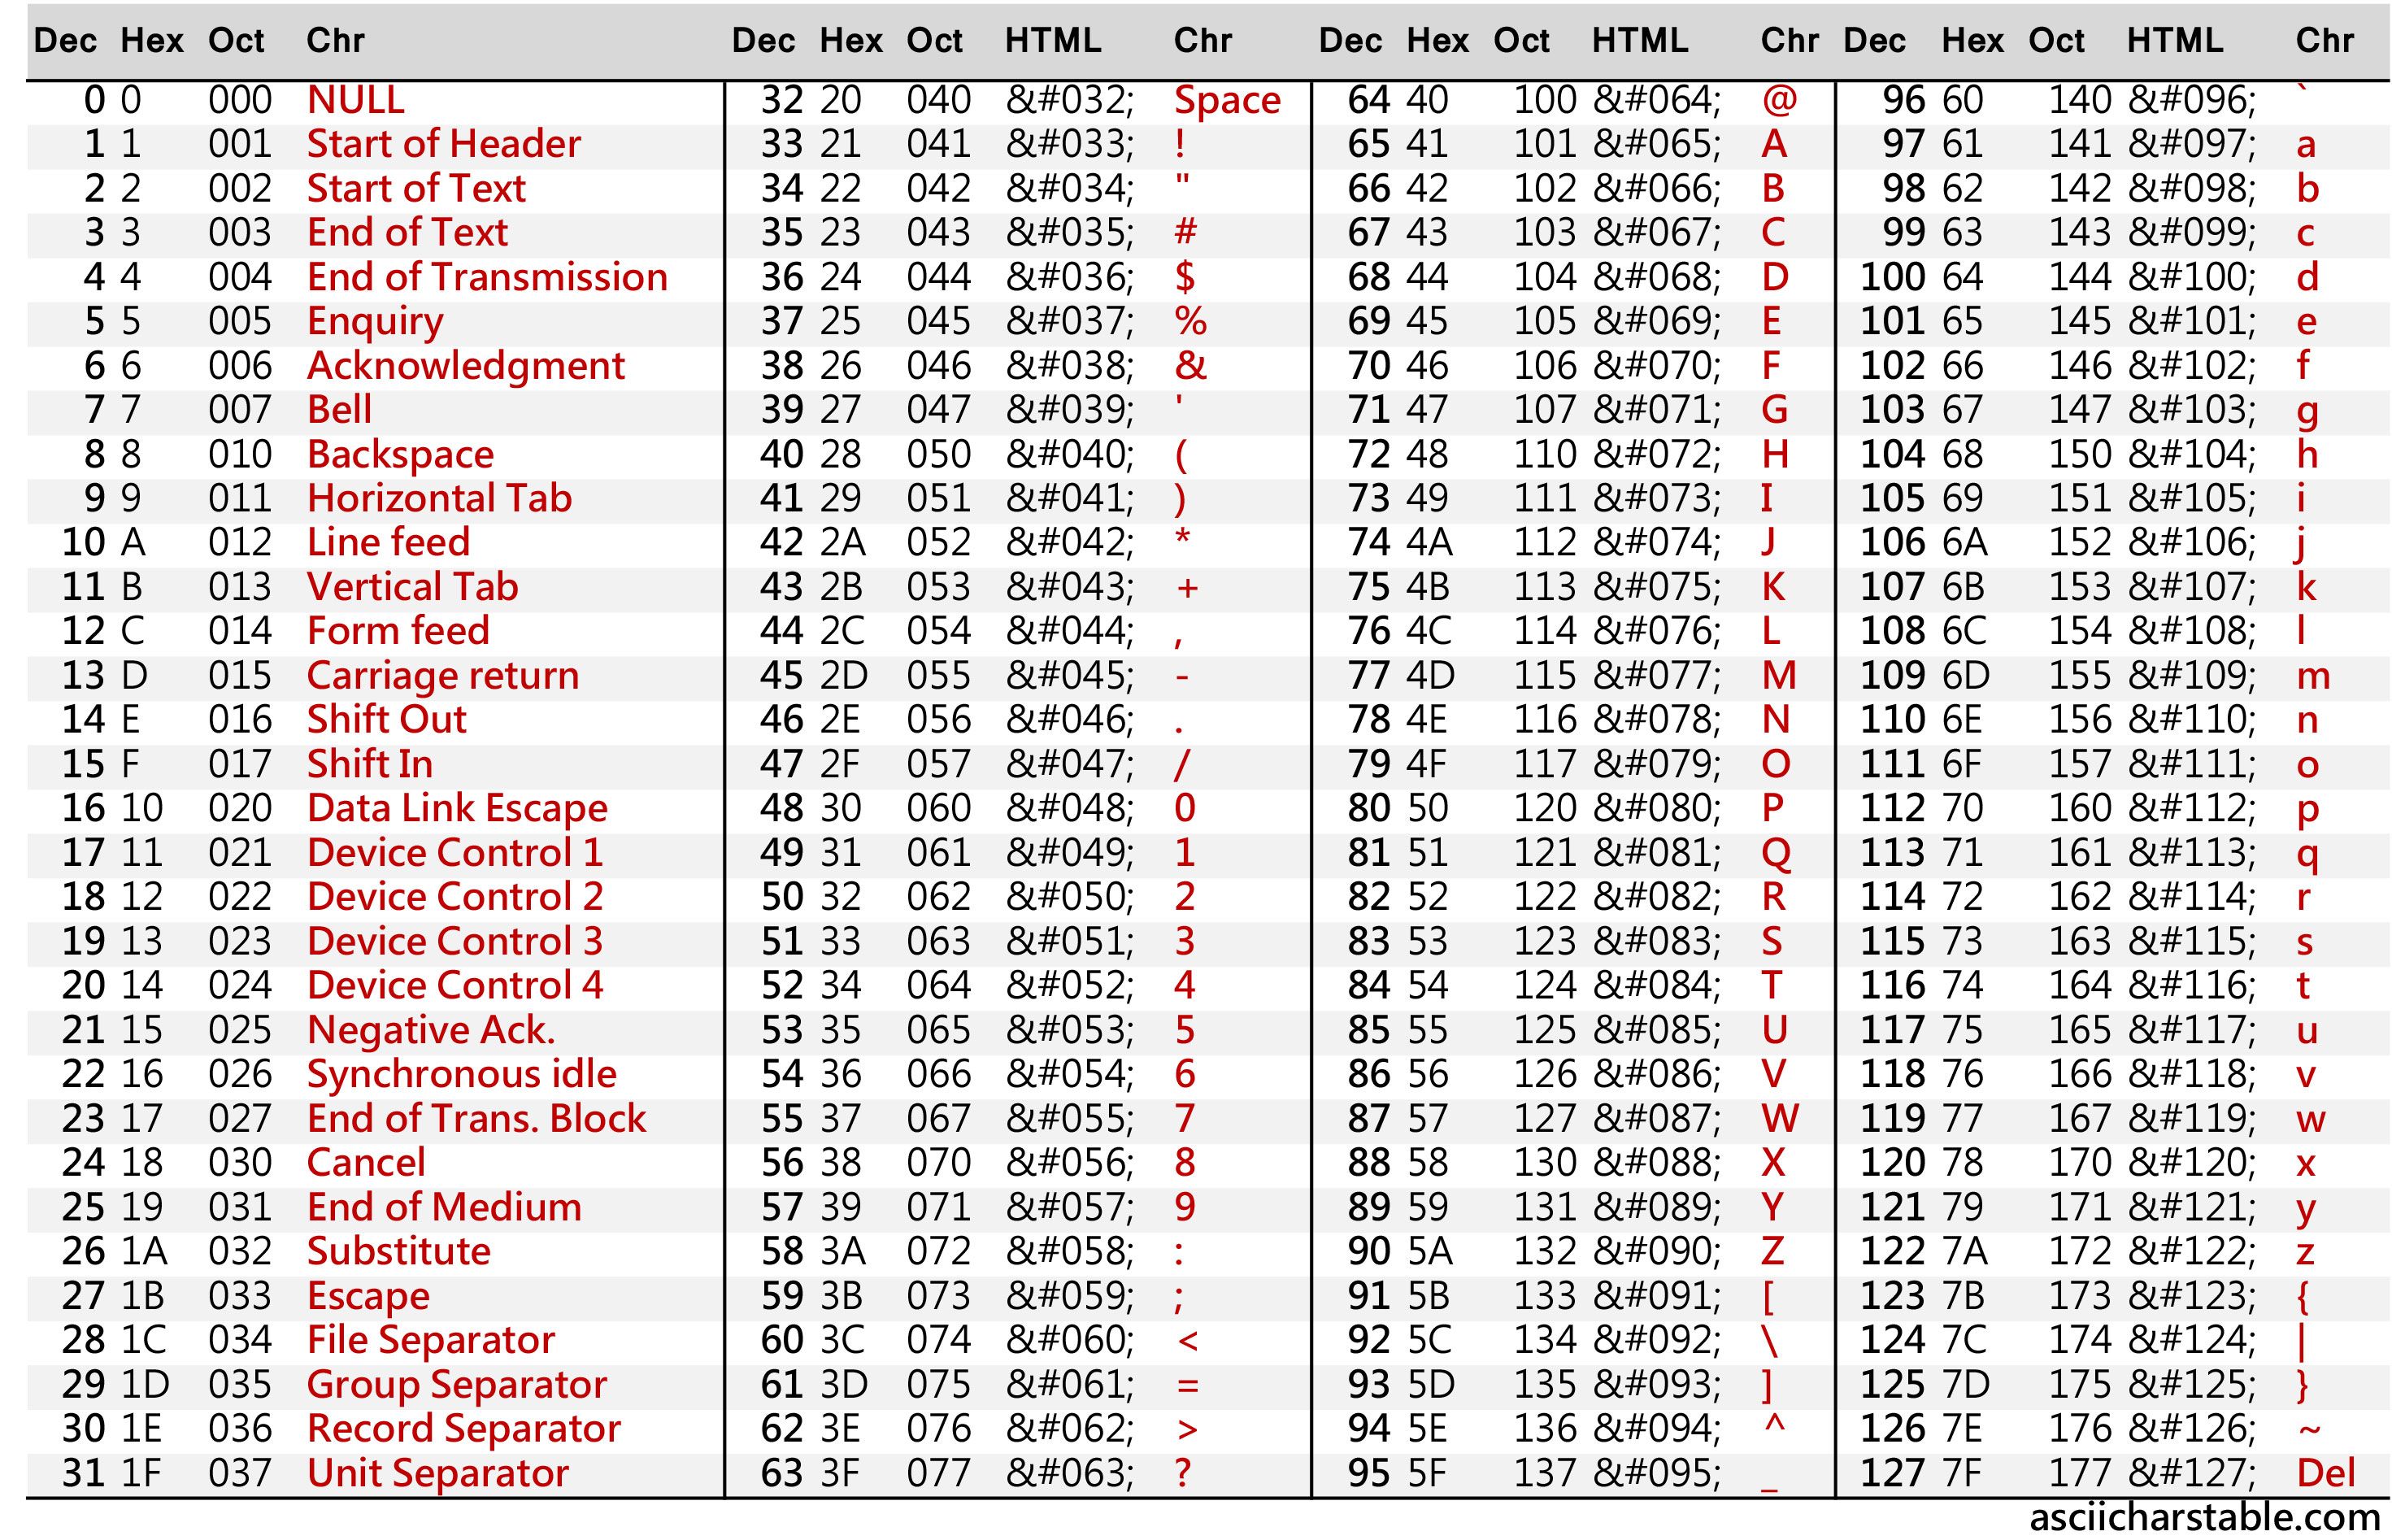
Tabulka 1: ASCII tabulka – rozsah znaků 0 ÷ 127 [4]
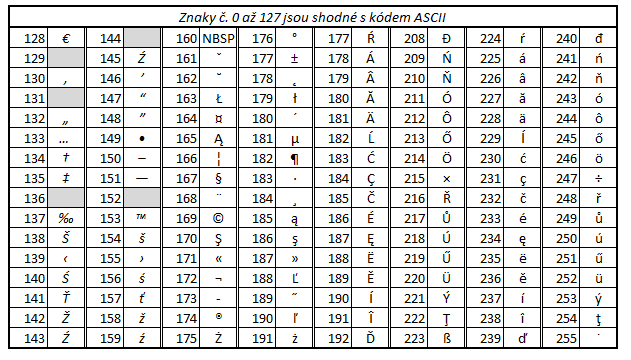
Tabulka 2: ASCII tabulka Windows 1250 – rozsah znaků 128 ÷ 255 [5]
Unicode – problém jednotného kódování do národních znaků se snaží vyřešit kódování Unicode. Unicode přiřazuje každému znaku jedinečné číslo, nezávisle na platformě, nezávisle na programu, nezávisle na jazyku. Často se používá pro presentace na Webu. Existují 3 druhy kódování Unicode:
- UTF-8 pracuje s osmibitovým kódováním, jeden znak může být vyjádřen jedním až čtyřmi byty, znaky bez diakritiky jsou obvykle vyjádřeny jedním bytem
- UTF-16 pracuje se šestnáctibitovým kódování
- UTF-32 pracuje se s dvaatřicetibitovým kódováním znaků, znaky bez diakritiky mohou obsahovat 24 nulových bitů a 8 nenulových bitů shodných s ASCII
Pozn.: Někdy je jeden znak ukládán ve dvou bytech. Pak druhý byte může obsahovat např. vlastnosti pro zobrazení znaku (velikost, tučnost, kurzívu atd.).
Algoritmus HexadecimalniPrevodPodprogramValidaceZnakNaPoziciASCIIPoziceZnakuASCII
- Popis: Vývojový diagram převodu čísla z desítkové do šestnáctkové soustavy zobrazené v 1 Bytu
- Zadání: Zkuste vymyslet algoritmus, který převede číslo z intervalu 0 až 255 zadané v desítkové soustavě do šestnáctkové soustavy včetně funkce Validace zadaného čísla. Dále specifikujte funkci pro určení znaku na určité pozici v ASCII - ZnakNaPoziciASCII - na číslo a obráceně, tj. navrácení pozice určitého znaku - PoziceZnakuASCII
- Řešení:
- Podprogramy - funkce:
Asi vnímáte, že podstata našeho úkolu je stejná jako v předchozím případu převodu z desítkové do dvojkové soustavy. Hlavní rozdíl je v celočíselném dělení a zbytku po celočíselném dělení hodnotou 16, namísto hodnoty 2. Pak vyvstává otázka, proč je tento příklad zařazen zrovna do této kapitoly? Jak jste se již dočetli, šestnáctková (hexadecimální) soustava využívá jak číslice, tak i písmena. U předchozího příkladu jsme použili pro připojení textu "1" nebo "0" rozhodovací blok, který testoval, zda zbytek po celočíselném dělení hodnotou 2 je roven 0. Pokud ano, vložili jsme textový řetězec "0". Jak jste si mohli, všimnout v tabulkách ASCII jsou zastoupeny na jednotlivých pozicích určitým znakem – datový typ String (přesněji řečeno datový typ Char, který představuje znak - v C# je znak uváděn v jednoduchých, např. 'A'. Datový typ Char není ve Flowgorithm definován, proto využijeme datový typ String). Textový řetězec (datový typ String) obsahuje řetězec jednotlivých znaků poskládaných za sebou, uvozený a zakončený dvojitými uvozovkami. Lze tedy do něj psát i věty.
Vraťme se ale zpět k našemu nynějšímu zadání. Pokud zbytek po celočíselném dělení hodnotou 16 je větší než 9 (šestnáctková soustava obsahuje číslice "0" - "9") potřebujeme do textového řetězce připojit znak podle výše zbytku (znak "A" představuje hodnotu 10 u zbytku celočíselné dělení, znak "B" představuje hodnotu 11 atd. až znak "F" představuje konečnou hodnotu 15). Pro vložení znaku do hexadecimálního řetězce můžeme ve vývojovém diagramu např. využít více rozhodovacích bloků, kde bychom podle výše zbytku vkládali jednotlivá písmena, nebo vícenásobné větvení apod. My ale využijeme ASCII kódování (tabulku znaků), kde podle výše zbytku celočíselného dělení budeme vkládat z ASCII tabulky jednotlivé znaky. Abychom tento princip mohli využít, potřebujeme vytvořit podprogram ve formě funkce, který nám bude vracet hodnotu znaku nalezeného na určité pozici v ASCII. Tuto funkci navracející znak nazveme ZnakNaPoziciASCII.
Do této funkce budeme předávat celočíselný parametr předávaný hodnotou pojmenovaný:
- pozice – číslo pozice znaku, který hledáme v ASCII (datový typ Integer)
Ve funkci dále využijeme lokální proměnnou:
- znak – znak nalezený na určité pozici v ASCII (datový typ String)
Princip této funkce pro vyhledání znaku na specifikované pozici je, že celočíselný parametr pozice, který do funkce vstupuje je přetypován – konvertován, tj. převeden z datového typu Integer do jiného datového typu String. Výstupem funkce je vyhledaný znak (textový řetězec o jednom znaku) na zadané pozici.
Pro algoritmus budeme dále potřebovat opačný způsob, kdy do funkce vložíme znak a obdržíme pozici znaku v ASCII. Tuto funkci nám bude zajišťovat funkce PoziceZnakuASCII. Tento podprogram má následující vstupní parametr:
- znak – znak hledaný na určité pozici v ASCII (datový typ String)
Ve funkci využijeme lokální proměnnou:
- pozice – číslo pozice znaku, který hledáme v ASCII (datový typ Integer)
Princip funkce je téměř totožný s předchozí funkcí. Rozdílem je přetypování vstupního znaku na celé číslo, tím obdržíme pozici, na které se znak nachází.
Podstata algoritmu hexadecimálního převodu je téměř totožná s převodem do dvojkové soustavy. Hlavní rozdíl je celočíselné dělení a zbytek po celočíselném dělení hodnotou 16. Pro algoritmus jsou deklarovány následující lokální proměnné:
- decimalniHodnota – celočíselná hodnota v desítkové soustavě načtená z funkce Validace, která je totožná s funkcí Validace využité v převodu do binární soustavy (datový typ Integer)
- zbytek – celočíselná hodnota zbytku po celočíselném dělení 16 (datový typ Integer)
- hexadecimalniText – textový řetězec jenž představuje konvertované číslo z desítkové do šestnáctkové soustavy (datový typ String)
Hlavní podstatou, kterou nám tento příklad ukazuje, je následný proces přiřazení (výraz) po rozhodovacím bloku, který testuje zbytek po celočíselném dělení hodnotou 16. Jestliže tento zbytek je větší než 9, měli bychom namísto hodnoty vložit písmeno (znak), podle výše zbytku. Využijeme funkce pro obdržení znaku na určité pozici. Tato pozice je spočtena jako zbytek + PoziceZnakuASCII("A") – 10, tzn., že součet vypočtené zbytku po celočíselném dělení a rozdílu hodnoty 10 od pozice znaku "A" obdržené z funkce PoziceZnakuASCII. Tím získáme počet, o kolik pozic se máme posunout od znaku "A", abychom získali jednotlivý znak vyjadřujícím zbytek po celočíselném dělení. Pokud se pohybujeme v rámci číslic, tzn., není splněna podmínka většího než 9 (větev False vedoucí z rozhodovacího bloku), budeme pro určení počtu pozic, abychom obdrželi číslice využívat startovací pozici znaku "0". Výraz je následující hexadecimalniText = ZnakNaPoziciASCII(zbytek + PoziceZnakuASCII("0")) & hexadecimalniText. Obdržené znaky připojujeme do textového řetězce hexadecimalniText zleva. Ostatní bloky již byly popsány u příkladu převodu do binární soustavy.
4. Typy dat
Ve vyšších programovacích jazycích jsou vymezeny určité typy dat, které charakterizují obory hodnot proměnných a přípustné operace nad těmito hodnotami. Tyto typy jsou relativně nezávislé na skutečném uložení dat pro konkrétní typ počítače.
Běžné typy dat, jako celá čísla, reálná čísla, logické hodnoty, jednotlivé znaky, jsou z hlediska přípustných operací dále nedělitelné, jsou to tzv. jednoduché datové typy.
Existují i strukturované datové typy, (jako např. pole, záznamy, soubory, objekty), které se ve vyšších jazycích běžně používají.
Strukturovaný datový typ je tvořen dalšími typy – jednoduchými i strukturovanými.
V objektově orientovaných jazycích se dále zobecňují operace s datovými typy na metody. Metody jsou podprogramy, které pracují s daným typem. Mohou být velmi obecné a složité.
4.1. Zobrazení alfanumerických znakových údajů
Alfanumerické údaje = posloupnost písmen, číslic a speciálních znaků přípustných v kódu daného počítače. Tvoří je:
- Písmenné znaky : A, B, C, D,...,Z, a, b, c ,...,z
- Číslice jako znaky : 0, 1, 2,...,9
- Speciální znaky : , : .; / + - * ... (ne každý kód připouští všechny speciální znaky).
Alfabetické údaje jsou znaky malé a velké abecedy.
Numerickými údaji ve znakové formě jsou číslice, znaménka + a -, desetinná tečka/čárka. Výhodou ukládání čísel ve znakové formě je jejich snadné prohlížení a přenositelnost. Obvykle však procesory s takovým uložením neumí počítat nebo je výpočet pomalejší. Proto je možné ukládat čísla také v binární formě jako čísla celá nebo reálná. Takové uložení je i úspornější. Existují i další způsoby uložení numerických dat, např. tzv. zhuštěný tvar, kdy jsou v jednom bytu dvě číslice.
Skupina alfanumerických znaků může být určena:
- Pevným počtem znaků (př. databáze a některé programovací jazyky)
- Počtem znaků uvedeným binárně před prvním znakem skupiny (př. standardní řetězce v Turbo Pascalu a Delphi)
- Zakončením skupiny jedním bytem obsahujícím binární nulu (př. řetězce v jazycích C a jeho klonech)
- Odkazem na dlouhý řetězec znaků uvedený dvěma čtveřicemi bytů, obsahujícími délku řetězce a počet současného užití tohoto řetězce (př. dlouhý řetězec v Delphi)
4.2. Zobrazení celých čísel
V počítači se zobrazují jinak celá a jinak reálná čísla. V dalším textu je uvedena hlavní myšlenka tohoto zobrazení. Konkrétní implementace zobrazení čísel jsou u jednotlivých počítačových systémů často mírně odlišné, podstata problému zobrazení ale zůstává zachována.
Celá čísla v binárním tvaru se zobrazují v tzv. pevné řádové čárce. Pro zobrazení celého čísla lze použít jeden, dva nebo 4 byty. Počet použitých bytů udává možný rozsah ukládaných hodnot. Dále se rozlišuje, zda uvažujeme číslo se znaménkem nebo bez něho.
Celá čísla jsou vyjádřena posloupností 0 a 1 ve dvojkové soustavě. Při převodech mezi soustavami se vychází ze skutečnosti, že každé celé číslo lze vyjádřit polynomem mocnin základu číselné soustavy. Tedy:
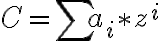
kde:
-
z ... základ číselné soustavy (např. 2, 8, 10, 16)
- i ... řád
-
n ... počet číslic
-
ai ... jednotlivé číslice
Př.:
1234 = 1*103 + 2*102 + 3*101 + 4*100
1234 = 1*210 + 0*29 + 0*28 + 1*27 + 1*26 + 0*25 + 1*24 + 0*23 + 0*22 + 1*21 + 0*20
Často se zobrazuje jedno číslo v jednom slově, tj. ve dvou bytech.
Znaménkový bit je obvykle bit s nejvyšším řádem - viz Obrázek 1.
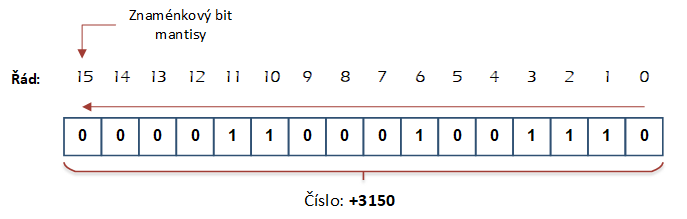
Obrázek 1: Celé číslo - znaménkový bit
Potom zbývá 15 bitů pro vlastní hodnotu čísla => největší zobrazitelné kladné celé číslo je:
215 - 1 = 32 767
Ve znaménkovém bitu je u kladného čísla 0 a číslo se zobrazuje tzv. v přímém tvaru (tj. je převedeno přímo z desítkového tvaru do binárního). Pro záporná čísla je ve znaménkovém bitu 1. Vlastní hodnotu záporného čísla lze vyjádřit třemi způsoby:
-
V přímém tvaru – hodnota záporného čísla je přímo uložena v dalších bitech
-
V inversním kódu – všechny 0 jsou zaměněny za 1 a naopak
-
Ve dvojkovém doplňku (do kapacity soustavy) - shoduje se s inversním kódem, ke kterému byla přičtena jednička
Obrázek nám ukazuje, jak je záporné číslo zobrazeno ve dvojkovém doplňku - viz Obrázek 2.
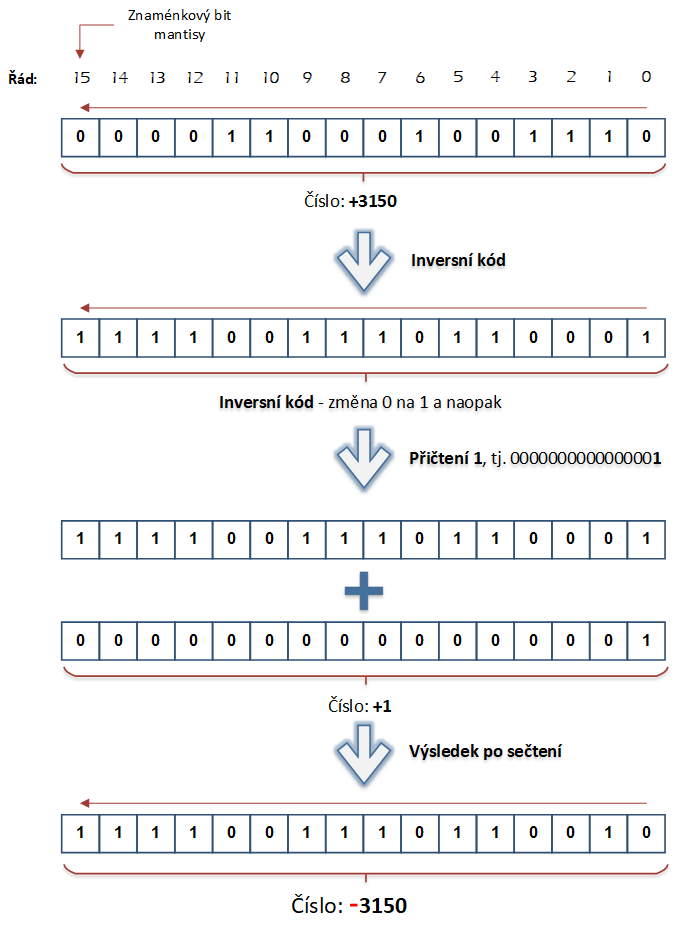
Obrázek 2: Zobrazení záporného celého čísla ve dvojkovém doplňku
4.3. Aritmetika s celými čísly
Veškeré aritmetické operace jdou převést na sčítání.
Odečítání lze provést tak, že se v odečítateli změní znaménko (převede se do doplňkového kódu) a sečte se s odčítancem.
Násobení spočívá v kombinaci posouvání 1. násobitele vlevo podle 2. násobitele a sérii sčítání.
Dělení spočívá v odečítání a posouvání vpravo.
Víme, že při sčítání dvou číslic v desítkové soustavě zapisujeme při překročení devítky jen pravou číslici ze součtu do výsledku a levá jednička je tzv. přenos, který přičteme k dalším číslicím vlevo.
Např.:
2+ 2 = 4, přenos 0
7 + 8 = 5, přenos 1
Podobně ve dvojkové soustavě může být výsledkem sčítání dvou číslic - viz Tabulka 1.
|
Sčítanec a |
Sčítanec b |
Přenos |
Výsledek |
Výsledný přenos |
|
0 |
0 |
0 |
0 |
0 |
|
0 |
1 |
0 |
1 |
0 |
|
1 |
0 |
0 |
1 |
0 |
|
1 |
1 |
0 |
0 |
1 |
|
0 |
0 |
1 |
1 |
0 |
|
0 |
1 |
1 |
0 |
1 |
|
1 |
0 |
1 |
0 |
1 |
|
1 |
1 |
1 |
1 |
1 |
Tabulka 1: Přenos
Pozn.: Doplněk ke dvojkovému číslu lze rychle vytvořit tak, že se opisují číslice ( 0 ) zprava, tj. od nejnižšího řádu, tak dlouho, až se narazí na 1. jedničku, ta se rovněž opíše a pak se již zaměňují 0 za 1 a 1 za 0. Druhým způsobem je vytvořit inversní kód a k němu přičíst jedničku.
Pokud při aritmetické operaci je výsledek mimo rozsah zobrazitelný pro daný typ celého čísla, dojde k tzv. přetečení. Výsledkem sčítání dvou kladných čísel může být záporné číslo, neboť došlo k přetečení do znaménkového bitu.
Přetečení při sčítání 2 čísel:
(18 926)10 (0 100 100 111 101 110)2
(16 385)10 (0 100 000 000 000 001)2
-------------- ------------------------------------
(35 311)10 (1 000 100 111 101 111)2 = (-30 225)10 !!!
4.4. Zobrazení reálných čísel
Reálná čísla nelze obecně v počítači přesně zobrazit, protože paměťový prostor pro jejich zobrazení je omezený (např. 2–4 slova resp. 4–8 bytů). Ze stejných důvodů se nemohou zobrazit ani všechna racionální čísla. Obecně lze zobrazit pouze číslo z určitého intervalu a s jistým maximálním počtem platných číslic, daných délkou zobrazení. Přesně lze zobrazit pouze ta reálná čísla, která lze vyjádřit jako konečnou posloupnost kladných a záporných mocnin čísla 2, přičemž počet těchto mocnin s koeficienty 0 a 1 je menší, než počet bitů rezervovaných pro zobrazení reálného čísla.
Reálné číslo se zobrazuje v tzv. semilogaritmickém tvaru nebo též jako číslo s pohyblivou řádovou čárkou (viz Obrázek 1):
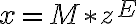
kde:
x ... zobrazované číslo
M ... mantisa v normalizovaném tvaru <0.5,1)
z ... 2
E ... exponent <-128,127>

Obrázek 1: Zobrazení reálného čísla
Mantisa obsahuje číslo v normalizovaném tvaru. Exponent určuje, o kolik míst je třeba posunout řádovou tečku, a to, je-li:
- exponent > 0 (|číslo| > 1), pak vpravo
- exponent < 0 (|číslo| < 1), pak vlevo
Existují různé modifikace tohoto způsobu zobrazení v konkrétním počítači, podstata problému zobrazování zůstává. Počet bitů mantisy a exponentu závisí na typu počítače, např. 16 bitový počítač: mantisa 24 bitů, exponent 8 bitů tj. 32 bitů (4 byte, 2 slova); čísla mají přesnost 6 až 7 platných číslic a rozsah je asi 10-38 až 1038.
Obvykle se pro zobrazení reálného čísla používají 4, 6 a 8 bytů.
Při zobrazení reálného čísla se uvažují 3 vlastnosti zobrazení:
- Největší zobrazitelné číslo
- Nejmenší kladné číslo různé od 0, nebo číslo, které, když je přičteno k 1.0, tuto hodnotu nezmění
- Počet platných dekadických číslic
Pozn.: Přesně lze zobrazit jen taková reálná čísla, jejichž desetinnou část lze vyjádřit jako součet mocnin jedné poloviny. Ostatní čísla se při převodu z desetinného čísla a ve výsledku aritmetické operace zaokrouhlují. Zde může být zdroj velmi nepříjemných chyb.
!!! V žádném případě se nedoporučuje porovnávat dvě reálná nenulová čísla X a Y na rovnost. Tuto úlohu je třeba převést na:
- Porovnání v relaci „větší“ (X > Y), pokud první člen roste, nebo „menší“ (X < Y), pokud první člen klesá
- Požadavek, aby absolutní hodnota rozdílu byla menší než dostatečně malé číslo (abs(X - Y) < Eps)
4.5. Ilustrace nepřesného zobrazení
V řadě iteračních úloh
mohou chyby ze zaokrouhlení způsobit zhroucení výpočtu. Na
následujícím příkladu si ukážeme vliv nepřesnosti reálného čísla, což může vést
k chybným výsledkům. Tento příklad však potřebuje různé datové typy pro uložení hodnoty reálného čísla, což v aplikaci Flowgorithm nelze, protože obsahuje pouze datový typ Real.
Algoritmus NepresneZobrazeni
- Popis: Vývojový diagram nepřesnosti zobrazení reálného čísla
- Zadání: Vymyslete algoritmus, který poukáže na nepřesnost zobrazení reálného čísla v závislosti na zvoleném datovém typu. Pro reálné číslo uložené v proměnné x zvolte datový typ float a pro proměnnou y zvolte datový typ double. Pro ilustraci nepřesnosti zvolte hodnotu výrazu x = (n+1) * x – 1. V každé iteraci pro jednotlivá n bude do výrazu vložena hodnota proměnné x, která odpovídá výrazu x = 1/n. Zvolte dva cykly s krokem, kde vnořený cyklus proběhne 30-krát pro každou hodnotu n. Tento vnořený cyklus bude zaznamenávat číslo iterace pomocí proměnné iterace. Ve vnějším cyklu bude postupně nastavena hodnota proměnné n od 1 do 10. Výsledek umístěný na řádku pro každou iteraci bude obsahovat aktuální hodnotu proměnných n; iterace; x; y. U výpisu výsledků za každou 10 řádku vložte prázdnou řádku
Řešení:
Vzhledem k tomu, že Flowgorithm v současné době nedisponuje možností výběru z různých datových typů, je pomocí následujícího odkazu zobrazen vývojový diagram vytvořený v aplikaci Visio od společnosti Microsoft, která umožňuje vytvářet vlastní vývojové digramy, ale neumožňuje z nich generovat kód do různých programovacích jazyků.
Jak bylo řečeno v zadání, do reálné proměnné x uložíme hodnotu 1/n, kde n je celé číslo. Potom budeme v každé iteraci vnitřního cyklu opakovaně vypočítávat výraz (n+1) * x - 1. Pokud tento výraz upravíme dosazením za x = 1/n, obdržíme (n+1)* 1/n – 1. Po vynásobení, odstranění závorek a provedení sčítání a odečítání, obdržíme opět 1/n.
Pokud však neprovedeme algebraické úpravy, ale budeme opakovaně provádět výpočty (n+1) * x - 1, dojde k tomu, že přesný výsledek 1/n obdržíme jen pro n = 2k, kde k = 0,1,2, ... Pro jiná n dojde k divergenci a získáme zcela nesprávný výsledek již po několika (10–30) opakováních, a to nezávisle na programovacím jazyku a přesnosti zobrazení reálného čísla.
Pro algoritmus jsou deklarovány následující lokální proměnné:
- iterace – číslo iterace (v C# datový typ int)
- n – celé číslo ve vnějším cyklu představuje dělitele, ve vnitřním cyklu hodnotu umístěnou ve výrazu v závorce (datový typ int)
- x – reálné číslo – velikost 4 Byte, přesnost 7 číslic, rozsah čísel od ±1.5*10-45 do ±3.4*1038 (v C# datový typ float)
- y – reálné číslo – velikost 8 Byte, přesnost 15–16 číslic, rozsah čísel od ±5.0*10-324 do ±1.7*10308 (v C# datový typ double)
Algoritmus se skládá ze dvou cyklů. Vnější cyklus zajišťuje změnu hodnoty proměnné n od hodnoty 1 do hodnoty 10. V tomto cyklu jsou nastaveny počáteční hodnoty proměnné x a y pomocí výrazu 1/n. Ve vnitřním (zapouzdřeném) cyklu je v první iteraci provedeno dosazení počáteční hodnoty z proměnné x do výrazu (n+1)*x– 1. V další iteraci (iteracích) je již dosazována vypočtená aktuální hodnota uložená v proměnné x (tato hodnota byla spočtena v předchozí iteraci). Stejný postup je aplikován i na výpočet hodnoty u proměnné y. Kvůli zvýšení čitelnosti výsledků jednotlivých iterací je zajištěno vložení prázdné řádky po každých deseti vypsaných řádcích s výsledky. Podmínka specifikovaná uvnitř rozhodovacího bloku tedy testuje, zda již proběhlo 10 iterací.
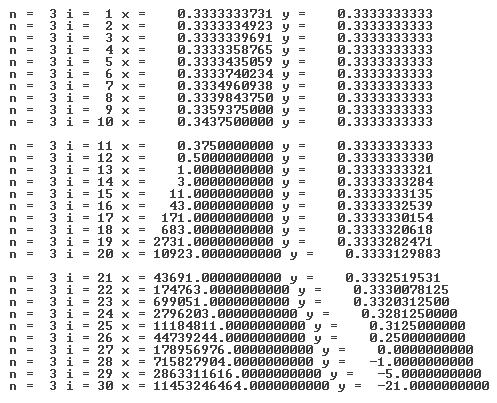
Výstup algoritmu - Nepřesnost zobrazení reálného čísla (viz NepresneZobrazeni)