Kódování
| Sitio: | Moodle ZČU |
| Curso: | KVD/UIN Úvod do informatiky pro vzdělávání - šablona |
| Libro: | Kódování |
| Imprimido por: | Nepřihlášený host |
| Día: | domingo, 8 de noviembre de 2026, 19:28 |
Tabla de contenidos
- 1. Přenosový kanál
- 2. Kódování
- 3. Rovnoměrné kódy
- 3.1. Váhový BCD kód
- 3.2. Cvičení k BCD kódu a kódu N+3
- 3.3. Symetrické váhové kódy
- 3.4. Cvičení k symetrickému váhovému kódu
- 3.5. Odčítání převedené na sčítání s doplňkem
- 3.6. Cvičení k odčítání převedenému na sčítání s doplňkem
- 3.7. Kódy se změnou v n řádech
- 3.8. Cvičení ke kódu se změnou v n řádech
- 3.9. Shrnutí
- 4. Nerovnoměrné kódy
- 5. Typové příklady z kódování ke druhému testu
1. Přenosový kanál
Pokud chápete přenos dat především jako součást komunikace, při níž je důležité předání nějaké informace, je důležité popsat prostředí, v němž se uskutečňuje.
 Když si vzpomenete, že jsme za nositele
informace označili signál, co je třeba pro přenos mezi zdrojem a příjemcem dat zajistit?
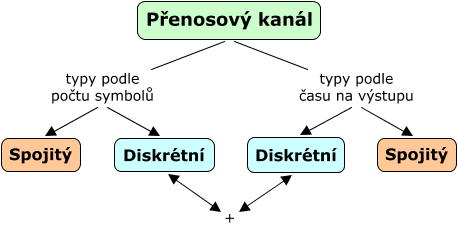
Prostředí pro přenos nazýváme přenosový kanál. Podle typu signálu, který je přenosovým kanálem přenášen, ho můžeme dělit na diskrétní a spojitý. Pro využití v oblasti digitálních technologií bereme v úvahu digitální signál, tudíž se budeme dále zabývat pouze diskrétním přenosovým kanálem.
Dokážete vyjmenovat tři základní kroky, v nichž
se převádí analogový signál na digitální?
Obr. 1: Typy přenosového kanálu.
Diskrétní přenosový kanál umí pracovat s konečným počtem symbolů. Důležité ovšem je, kdy se může symbol objevit na výstupu. Bylo by obtížné pracovat s kanálem, v němž by se tak mohlo dít v libovolném časovém okamžiku. Proto navíc v praxi bereme v potaz diskrétní přenosový kanál s diskrétním časem, v němž se na výstupu může objevit symbol pouze v určitém čase (typy přenosových kanálů jsou shrnuty se zvýrazněním pro nás hlavního na obrázku výše).
Kde byste našli v historii předobraz
této myšlenky?
1.1. Problémy
I když je cílem komunikace bezvadný přenos dat tak, aby informace na vstupu a výstupu byly totožné, může dojít k různým problémům, které mohou způsobit, že přenosový kanál nebude pracovat tak, jak bychom očekávali:
- Porucha – přenos může být narušen tak, že bude utlumen (částečně se ztratí schopnost systému pracovat v přípustných mezích), či zkreslen (část přenášených dat bude pozměněna).
- Šum – veličina různé fyzikální povahy, která snižuje celkově kvalitu kanálu, čímž ovlivňuje negativně velikost přenesené informace za jednotku času.
Obr. 2: Oprava poruchy. (Zdroj: Commander,
U.S. Naval Forces Europe-Africa/U.S. 6th Fleet, Public domain, prostřednictvím Wikimedia Commons).
 Máte nějaké návrhy, jak s problémy v přenosovém
kanálu bojovat?
1.2. Shrnutí
 U problémů přenosového kanálu nás zajímá jeho spolehlivost (je jistě nepřijemné, když se z důvodu významné
poruchy přenos vůbec neuskuteční) a bezpečnost (podobně je nepříjemné, když by porucha či šum nebyly náhodné, ale úmyslně ovlivnitelné tak, jak by si někdo jiný přál).
Zdroje
Podrobnější informace k tématu studijního článku můžete nalézt v následujících zdrojích:
- JIROUŠEK, Radim a kol. Principy digitální komunikace. Voznice: LEDA, 2006, 320 s. ISBN 80-7335-084-X.
- KOCOUREK, Petr a Jiří NOVÁK. Přenos informace. Praha: ČVUT Praha, 2004, 164 s. ISBN 80-010-2892-5.
- MAREŠ, Milan. Slova, která se hodí, aneb, Jak si povídat o matematice, kybernetice a informatice. Praha: Academia, 2006. 348 s. ISBN 80-200-1445-4.
- PROKOPOVÁ, Zdeňka. Základy informatiky: učební texty vysokých škol. Zlín: VUT v Brně, 1998, 98 s. ISBN 80-214-1129-5.
2. Kódování
Při přenosu je obvykle třeba dvojího převodu (přiřazení hodnot elementárním signálům a určení logické výstavby při tvorbě symbolů z nich). Připodobnit to můžeme Morseově abecedě, kterou někteří možná ještě pamatují z dětských let. Logiku tvorby písmen z teček a čárek do značné míry tvořila pravděpodobnost jejich výskytu v anglických slovech. Tečce pak mohl být pro přenos jako elementární signál např. přiřazen krátký hvizd a čárce dlouhý hvízd. V obou případech hovoříme o kódování. V prvním z nich se ovšem jedná o zdrojové, ve druhém o kanálové.
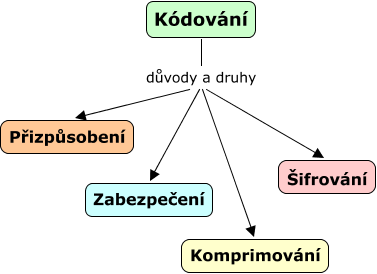
Obr. 3: Důvody pro kódování v digitálních technologiích.
 K čemu mu nám může být kódování v oblasti
digitálních technologií dobré vidíte na obrázku výše. Jak byste jednoslovné popisy rozvedli?
2.1. Definice kódování
Kódováním pro naše účely budeme rozumět zobrazení mezi množinami A a B (obecně ho můžeme zapsat K: A→B*), kde:
- Množina A je zdrojová abeceda tvořená zdrojovými znaky.
- Množina B je kódová abeceda tvořená kódovými znaky.
- Množina B* je množina kódových slov, která jsou tvořena konečnou neprázdnou posloupností z kódových znaků (=kód).
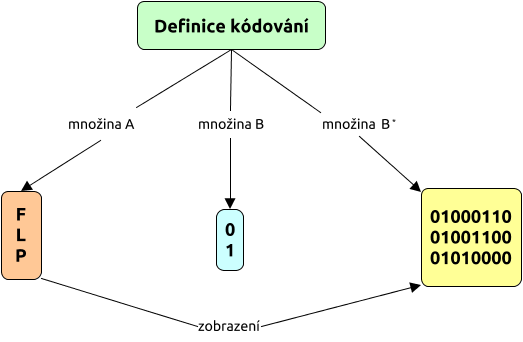
Obr. 4: Definice kódování. (Zdroj vlastní)
 Proč si v oblasti digitálních technologií
obvykle nevystačíme se zobrazením K: A→B?
Klíčovou vlastností kódování je, že jde o bijektivní zobrazení (tedy prosté zobrazení na).
Co uvedený pojem z matematiky značí?
Kódování se při vědomí existence přenosového kanálu může odehrávat na různých úrovních, jak ukazuje následující obrázek:
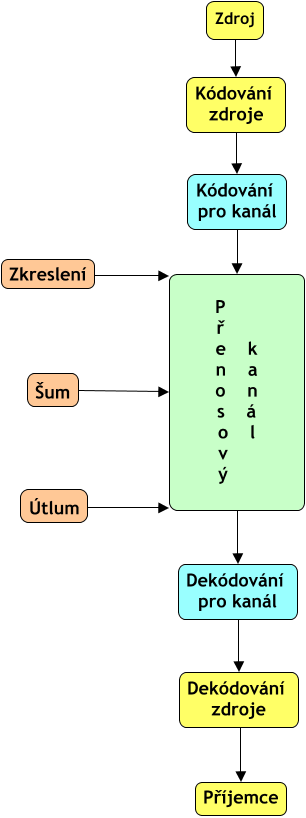
Obr. 5: Vztah kódování a přenosového kanálu. (Zdroj vlastní)
2.2. Cvičení: Morseova abeceda
- V dětských hrách bývá někdy Morseova abeceda představována jako šifra. Proč tomu tak při jejím obvyklém používání nebylo? Kdy by se opravdu jednalo o šifrování?
- Morseovu abecedu jsme v předchozí studijní kapitole představili jako binární kód, který používá jako kódové znaky ⋅ a -. V čem není toto tvrzení zcela přesné?
Tipy pro řešení
- Vzpomeňte si na obrázek v předchozí studijní kapitole o různých důvodech pro kódování.
- Zde vám pomůže uvědomění, o jaký typ zobrazení při kódování jde. Pokud by ani toto nepomohlo, pokuste se dekódovat zprávu .-.---
Návrh řešení
Návrh řešení si prohlédněte, až se pokusíte najít vlastní odpovědi.
 1. Je šifrování a kódování totéž? Kdy by
byla Morseova abeceda použita jako šifra?
2. Je Morseova abecena binární kód?
2.3. Vlastnosti kódů
Již víte, že kód je tvořen kódovými slovy. Jejich délku (=počet míst, která budeme nazývat bity, jak je zvykem, i když to není zcela přesné) budeme značit m. V případě binárního kódu je počet kódových slov L v rozmezí 1 ≤ L ≤ 2m.
Při výpočtu průměrné délky kódového slova využíváme délky kódových slov a znalosti pravděpodobnosti výskytu znaků zdrojové abecedy, kterým kódová slova odpovídají. Pro každé kódové slovo je vynásobíme a součiny sečteme. Průměrnou délku následně můžeme využít při výpočtu efektivnosti kódu, která se rovná podílu entropie a právě průměrné délky kódového slova.
 Co je základní vlastností, kterou má každý
kód?

Obr. 6: Vlastnosti kódů.
 Při dekódování můžeme pracovat s kódovanou
zprávou jako celkem K(a1; a2; ... an). Značným zrychlením však může být možnost plynulého dekódování tzv. znak po znaku K(a1);K(a2);... K(an). K tomuto Brockway McMillan napsal
v článku „Two inequalities implied by unique decipherability“ (Dvě nerovnosti implikované jednoznačnou dekódovatelností) v roce 1956 zkráceně, jestliže je kód dekódovatelný jednoznačně znak po znaku, platí pro něj Kraftova nerovnost.
Dnes je toto tvrzení známo jako McMillanova věta.
Obr. 6: Brockway McMillan. (Zdroj: public domain z http://www.nro.gov/history/csnr/leaders/directors/dir3.html
2.4. Dělení kódů
Ve cvičení k Morseově abecedě jsme se dostali k tomu, že kódy můžeme dělit podle počtu kódových znaků. Hledisek pro dělení
však můžeme mít mít mnohem více, jak je patrné z příkladného výčtu níže. Nebudete asi překvapeni, že jeden kód může spadat do různých kategorií.
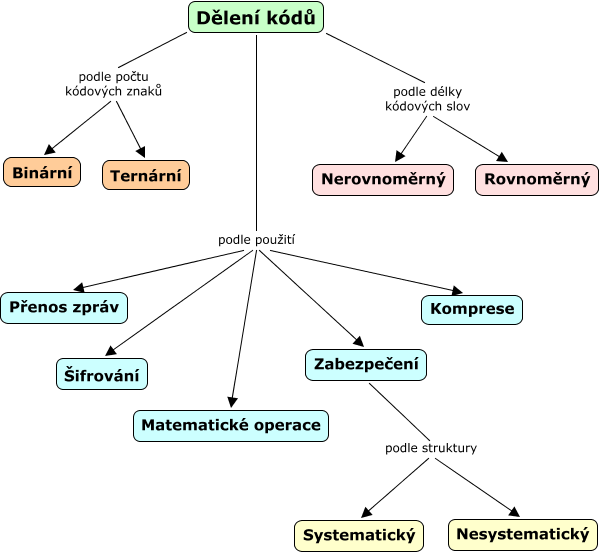
Obr. 7: Dělení kódů.
 Jaké znáte příklady, které odpovídají dělení
podle počtu kódových znaků?
Dělení kódů podle použití odpovídá zdůvodněním pro opodstatnění kódování, nad kterými jste se mohli zamyslet v úvodu ke kódování. Konkrétní příklady si k nim postupně v e-kursu přidáme.
Čím se liší rovnoměrné a nerovnoměrné kódy?
2.5. Shrnutí
 Kódování jsme v souladu s funkcemi v matematice definovali jako bijektivní zobrazení, jehož
významnou vlastností je, že je prosté. Důležité také je rozdělení kódování na zdrojové (logické) a kanálové (fyzikální). Mezi tyto dva druhy se velmi často vkládají ještě další stupně podle účelu kódování. Daný účel je proto vždy podmožinou
kódování.
Účel použití je zároveň jedním ze způsobů, jak můžeme kódy dělit do různých druhů. Stejný kód může patřit podle dělení do různých kategorií (být binární, rovnoměrný a použitelný pro matematické operace zároveň). Kódy můžeme mezi sebou porovnávat také
podle různých vlastností, jako jsou efektivnost, průměrná délka kódového slova apod.
Zdroje
Podrobnější informace k tématu studijního článku můžete nalézt v následujících zdrojích:
- JIROUŠEK, Radim a kol. Principy digitální komunikace. Voznice: LEDA, 2006, 320 s. ISBN 80-7335-084-X.
- KOCOUREK, Petr a Jiří NOVÁK. Přenos informace. Praha: ČVUT Praha, 2004, 164 s. ISBN 80-010-2892-5.
- MAREŠ, Milan. Slova, která se hodí, aneb, Jak si povídat o matematice, kybernetice a informatice. Praha: Academia, 2006. 348 s. ISBN 80-200-1445-4.
- PROKOPOVÁ, Zdeňka. Základy informatiky: učební texty vysokých škol. Zlín: VUT v Brně, 1998, 98 s. ISBN 80-214-1129-5.
3. Rovnoměrné kódy
Víte již, že rovnoměrný kód má všechna kódová slova stejně dlouhá (setkat se proto můžete i s názvem blokový kód). Příkladný výčet je na obrázku níže. S kódy pro zobrazení čísel v počítači jste se již podrobně seznámili, jiné rovnoměrné kódy poznáte nově v této kapitole a znakovým věnujeme samostatnou studijní kapitolu pozěji.
 Poznáte, v čem tkví jejich výhoda?
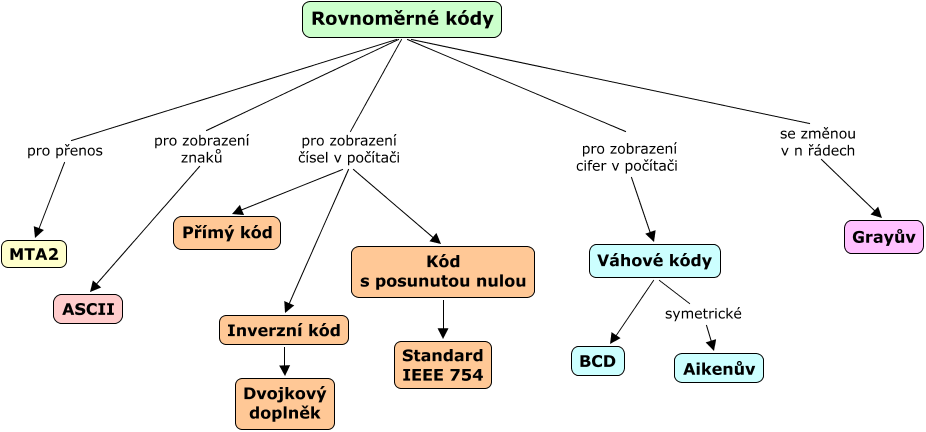
Obr. 8: Příklady rovnoměrných kódů.
Pokud budete brát v úvahu různou pravděpodobnost výskytu zdrojových znaků ve zprávách, dospějete nutně k názoru, že jsou to často kódy značně redundantní. Podle účelu použití kódu to může být chápáno jako záporná (např. v případě snahy o zakódování zprávy na co nejmenší počet bitů) i kladná (např. v případě snahy o vyšší zabezpečení, jak uvidíte v samostatné studijní kapitole později) vlastnost.
3.1. Váhový BCD kód
Váhové kódy se obvykle používají ke kódování cifer desítkové soustavy.
 Kolik bitů v takovém případě budete
minimálně potřebovat na tvorbu kódových slov?
Rovnoměrný kód nazveme váhový, když pro něj platí následující vztah:
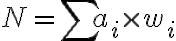
pro i = 0..m−1
- ai – kódový znak (v našem případě 0 nebo 1) na i. pozici v kódovém slově.
- wi – hodnota i. váhy (celé číslo od 0 do 9) v kódovém slově.
- m – délka kódového slova.
BCD kód
Mezi nejznámější váhové kódy patří BCD kód (Binary Coded Decimal), který má váhy w3 = 8, w2 = 4, w1 = 2, w0 = 1 (zkráceně 8421).
Jak v BCD kódu zakódujete cifru 3?
Na obrázku níže můžete porovnat zakódování desítkových cifer v BCD kódu a v kódu N+3. U druhého z nich neznáme váhy pozic. Kód N+3 vznikl tak, že cifře z desítkové soustavy je přiřazeno kódové slovo, které odpovídá zobrazení čísla z desítkové soustavy, které je o tři větší ve dvojkové soustavě na čtyřech bitech. Např. cifře 3 tedy přiřazuje kódové slovo, které odpovídá zobrazení čísla 6 (= 3 + 3) z desítkové soustavy do dvojkové na čtyřech bitech.
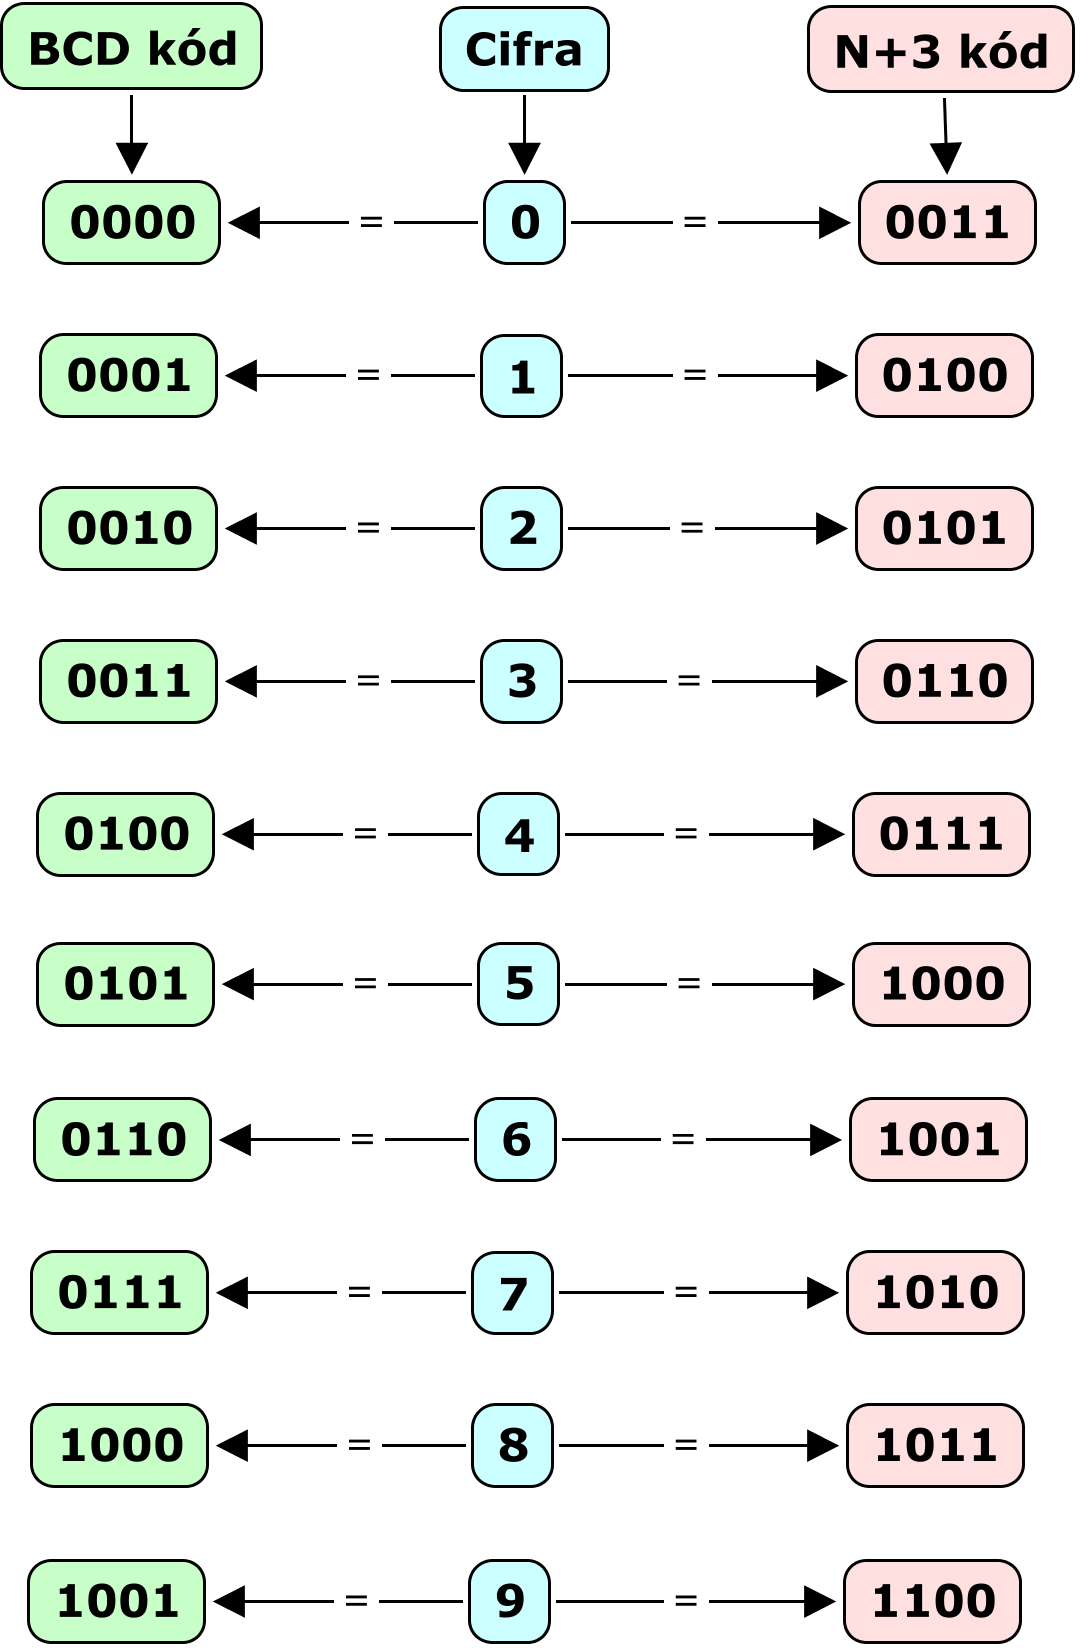
Obr. 9: Porovnání BCD kódu a kódu N+3.
3.2. Cvičení k BCD kódu a kódu N+3
V předchozí studijní kapitole jsme představili na závěr konkrétní podobu BCD kódu a kódu N+3. Co je výhodou každého z nich?
Tipy pro řešení
Zaměřte se způsob vzniku kódových slov pro jednotlivé cifry i na obrázek jako celek.
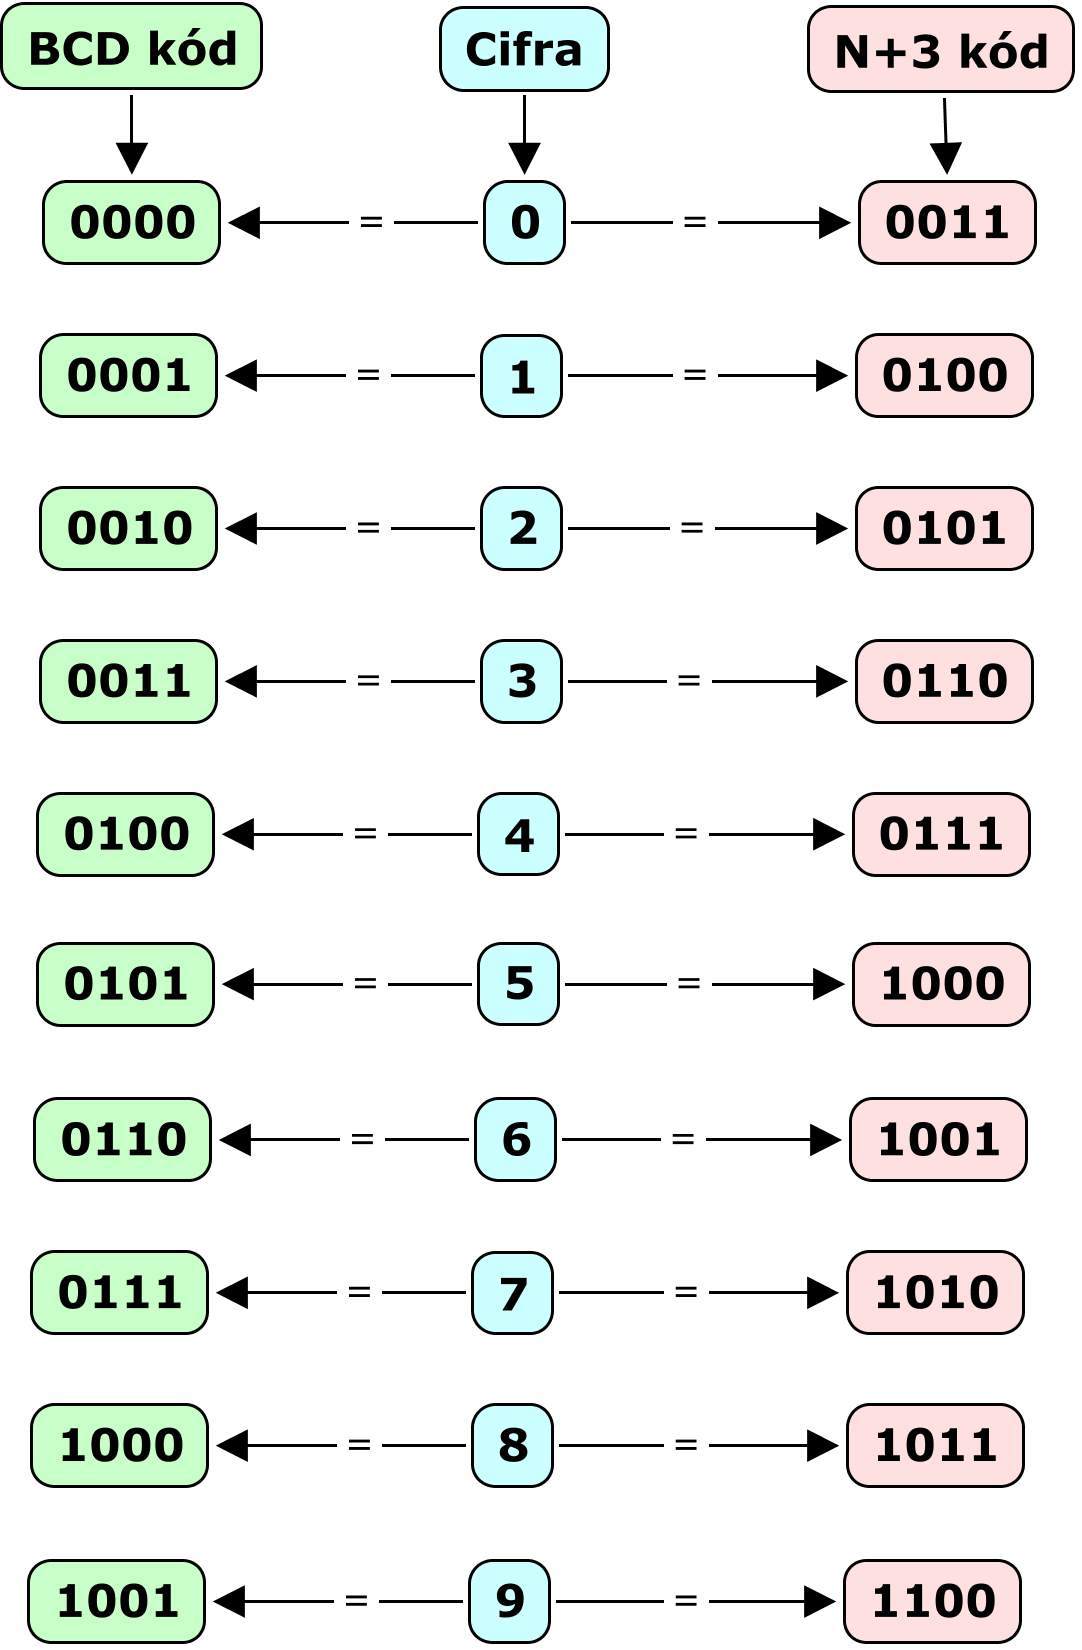
Obr. 9: Porovnání BCD kódu a kódu N+3.
Návrh řešení
Návrh řešení si prohlédněte, až se pokusíte najít vlastní odpovědi.
 1. Jaká je výhoda BCD kódu?
2. V čem tkví výhoda kódu N+3?
3.3. Symetrické váhové kódy
Ve cvičení jste zjistili, že BCD kód a kód N+3 mají každý výhodu v něčem jiném. Zásadní je, že výhodu snadné tvorby na základě znalosti vah a výhodu komplementarity kódových slov pro cifry, které dávají v součtu na dané pozici číslo 9, se podařilo v průběhu let v mnoha kódech spojit dohromady. Díky tomu vznikla nová třída symetrických váhových kódů.
Jedním z používaných kódů s oběma výhodami je Aikenův kód s váhami 2421. Na obrázku níže vídíte díky čárkovaným spojnicím naznačenou komplementaritu odpovídajících si dvojic. Barevně odlišená vodorovná osa naznačuje symetričnost kódu.
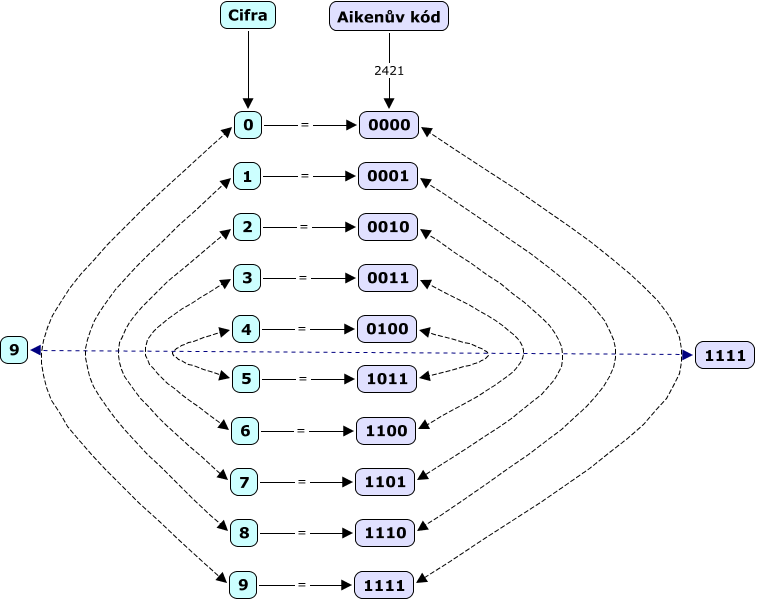
Obr. 10: Aikenův kód.
 Co je na vahách 2421 zajímavého, na co si musíte při jejich použití dát pozor?
3.4. Cvičení k symetrickému váhovému kódu
Zakódujte cifry dekadické soustavy symetrickým váhovým kódem, který má váhy w3 = 7, w2 = 5, w1 = 3, w0 = −6.
Tipy pro řešení
Vzpomeňte si na, jak se zakódování provádí (pro každou pozici binární kódový znak × váha). V souvislosti se symetričností nezapomeňte na komplementaritu (součet kódových slov odpovídajících komplementárním cifrám musí
být 1111).
Nenechte se zmást poslední váhou, která je záporná. Váhy mohou nabývat skutečně hodnot záporných, mohou to být i zlomky atd.
Návrh řešení
Návrh řešení si prohlédněte, až se pokusíte najít vlastní odpověď.
 Jak vypadá symetrický váhový kód 753-6?
3.5. Odčítání převedené na sčítání s doplňkem
Komplementární symetrické váhové kódy se s výhodou mohou využívat při převádění odčítání na sčítání s doplňkem. Obecně je tento způsob popsán na obrázku níže.
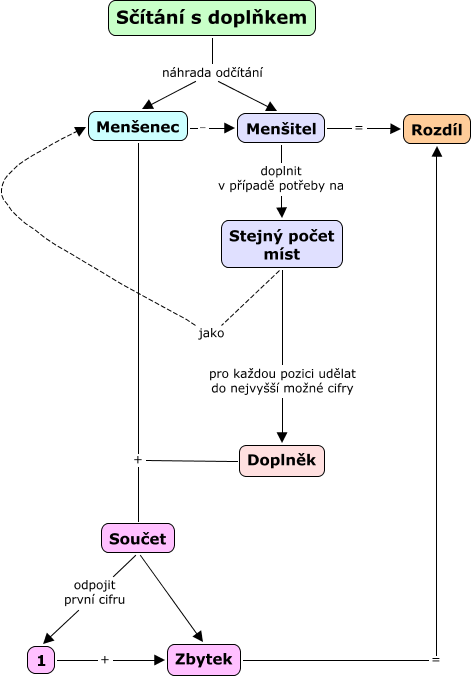
Obr. 11: Schéma převodu
odčítání na sčítání s doplňkem.
 Které okolnosti jsou pro převedení odčítání
na sčítání s doplňkem klíčové?
Pokud zůstaneme prozatím v desítkové soustavě, můžete si prohlédnout, jakým způsobem proběhne např. převod odčítání 321 − 98 na sčítání s doplňkem.
- Menšitele doplníte na stejný počet míst, který má menšenec, čímž dostaneme 098.
- Postupně naleznete doplněk pro všechny cifry menšitele. Konkrétně zde tedy 9 − 0 = 9; 9 − 9 = 0; 9 − 8 = 1; a tudíž je doplňkem menšitele 901.
- Provedete součet 321 + 901 = 1222.
- Vezmete první cifru výsledného součtu (vždy to bude jednička) a přičtete ji ke zbytku čísla: 222 + 1 = 223, což je správný výsledek odčítání 321 − 98, o které od začátku šlo.
V čem bude spočívat výhoda převodu odčítání na sčítání s doplňkem v binární soustavě při zohlednění technické realizace?
3.6. Cvičení k odčítání převedenému na sčítání s doplňkem
Proveďte odečtení 45610 − 8910 s čísly zobrazenými v Aikenově kódu převedením na sčítání s doplňkem.
Tipy pro řešení
Nejprve zobrazte jednotlivé cifry menšence i menšitele v Aikenově kódu, jehož podobu připomínáme následujícím obrázkem.
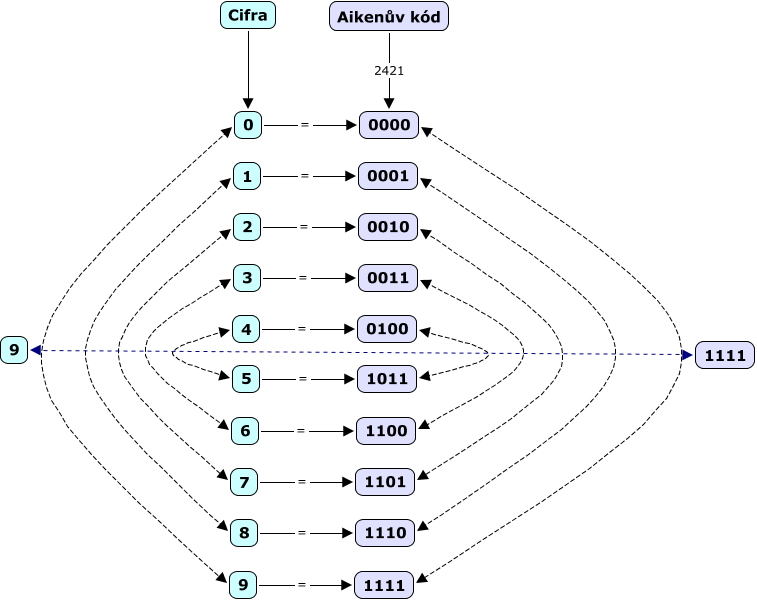
Obr. 10: Aikenův kód.
Posléze proveďte úpravu, aby měl menšitel stejný počet cifer jako menšenec.
Proveďte doplněk na každé pozici menšitele v binární podobě.
(Na pořadí prvních tří kroků nezáleží, ale je výhodné dělat doplněk menšitele až po převodu do binární podoby, protože se v takovém případě
jedná pouze o negaci bitů.)
Sečtěte menšence a doplněk menšitele.
Přičtěte přetečení.
Návrh řešení
Návrh řešení si prohlédněte, až se pokusíte o své vlastní.
 Jak bude vypadat odčítání 45610 − 8910 převedené na sčítání s doplňkem s čísly zobrazenými v Aikenově kódu?
3.7. Kódy se změnou v n řádech
Kódy se změnou v n řádech jsou charakteristické tím, že každá dvě sousední kódová slova se liší ve stejném počtu bitů.
Následující příklad ukazuje jeden z možných případů čtyřbitového kódu se změnou ve dvou řádech s vyznačením změn:
0000
||
0011
||
0101
||
1001
||
1111
||
1100
||
1010
||
0110
 Bylo by možné v příkladu výše získat
více kódových slov?
Významné uplatnění mají především kódy se změnou v jednom řádu. Děje se tak při převodu analogového signálu na digitální. Grayův kód je pak využit např. při označení pozic v Karnaughově mapě, která se používá při minimalizaci logických funkcí (více se k tomuto tématu dozvíte v dalším semestru v předmětu KVD/EPSV, zatím se alespoň podívejte na příklad pro tři vstupy na obrázku níže.
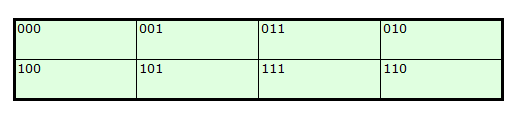
Obr. 12: Pozice v Karnaughově mapě pro tři vstupy.
Jaké zajímavosti si můžete v označení pozic povšimnout?
3.8. Cvičení ke kódu se změnou v n řádech
Vytvořte pětibitový kód se změnou v jednom řádu.
Tipy pro řešeni
Vhodné může být, když si nejprve určíte, kolik kódových slov těchto podmínek můžete získat. Následně je důležité si&nsbp;uvědomit, že tvorba by neměla vypadat náhodně, protože v takovém případě po získání určitého počtu slov již nepůjde jít dále, neboť by se kódová slova začala opakovat. Zároveň se při případném prvním nezdaru nevzdávejte, konkrétních správných řešení je více.
Návrh řešení
Na ukázku jednoho z možných řešení se podívejte, až se pokusíte o nějaké vlastní.
 Jak může vypadat jedna z možných podob
pětibitového kódu se změnou v jednom řádu?
3.9. Shrnutí
 Rovnoměrné kódy se vyznačují snadnou dekódovatelností, kterou potvrzuje i platnost Kraftovy nerovnosti. K již známým kódům pro zobrazení čísel v počítači jste poznali další, které slouží k zobrazení desítkových cifer. Pokud jde o váhový symetrický kód, lze ho snadno použít k převodu odčítání na sčítání s doplňkem. V praxi to vede k ekonomické úspoře. Kódy se změnou v n čádech potom můžeme využívat k převodu analogového signálu na digitální.
Zdroje
Podrobnější informace k tématu studijního článku můžete nalézt v následujících zdrojích:
- ADÁMEK, J. Kódování a teorie informace. Praha: ČVUT, 1991
- JIROUŠEK, Radim a kol. Principy digitální komunikace. Voznice: LEDA, 2006, 320 s. ISBN 80-7335-084-X.
- KOCOUREK, Petr a Jiří NOVÁK. Přenos informace. Praha: ČVUT Praha, 2004, 164 s. ISBN 80-010-2892-5.
- MAREŠ, Milan. Slova, která se hodí, aneb, Jak si povídat o matematice, kybernetice a informatice. Praha: Academia, 2006. 348 s. ISBN 80-200-1445-4.
- PROKOPOVÁ, Zdeňka. Základy informatiky: učební texty vysokých škol. Zlín: VUT v Brně, 1998, 98 s. ISBN 80-214-1129-5.
4. Nerovnoměrné kódy
Díky studijnímu článku Dělení kódů víte, že nerovnoměrný kód se vyznačuje tím, že se mezi kódovými slovy objevuje alespoň jedno, které má jinou délku než ostatní.
 V čem tkví výhoda této vlastnosti nerovnoměrných
kódů?
V dalších kapitolách se zaměříme na specifický druh nerovnoměrných kódů a jejich konstrukci.
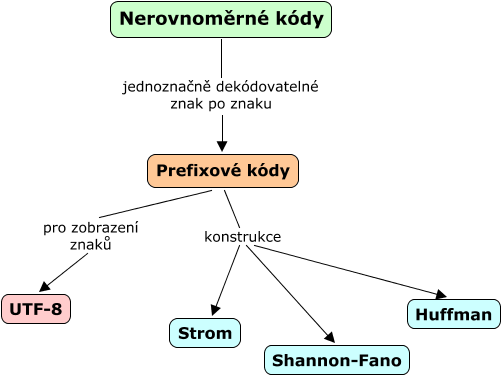
Obr. 13: Nerovnoměrné prefixové kódy a způsoby konstrukce.
4.1. Prefixové kódy
I u nerovnoměrných kódů můžete dosáhnout zajištění výhody, kterou poskytují kódy rovnoměrné v jednoznančné dekódovatelnosti znak po znaku. Takovéto kódy nesou označení prefixové, což značí, že žádné kódové slovo v nich není předponou jiného kódového slova.
Na obrázku níže můžete vidět ukázku jednoduchého nerovnoměrného prefixového kódu zdroje, který produkuje pouze tři znaky. Dva z nich se vyskytují ve zprávách se stejnou pravděpodobností, zbývající třetí s poloviční.
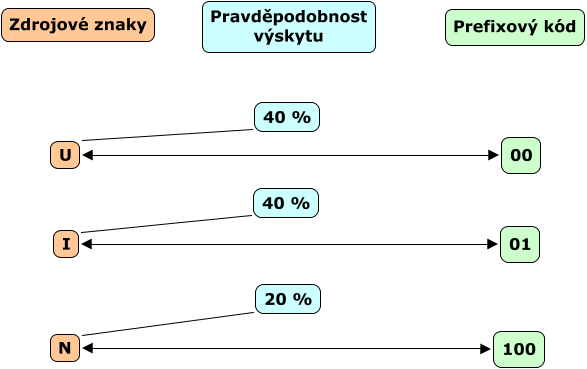
Obr. 14: Konkrétní příklad prefixového kódu.
 Jak byste za pomoci tohoto kódu dekódovali
zprávu
00011001000100?
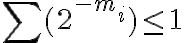 pro i 1 do L (nebo-li pro délky všech kódových slov). Pro kód z obrázku výše
je splněna, protože 1/2² + 1/2² + 1/2³ = 5/8 ≤ 1.
Jakou podmínkou je platnost Kraftovy nerovnosti?
4.2. Binární strom
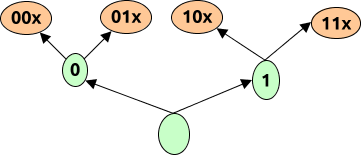
Existují různé způsoby konstrukce prefixových kódů, z nichž si postupně tři představíme. V prvním z nich využijeme ke konstrukci binární strom. Jeho základem je kořen (uzel), ze kterého vychází dvě větve (hrany) na různé strany. Jeden směr v celém stromu značíme 0, druhý 1.
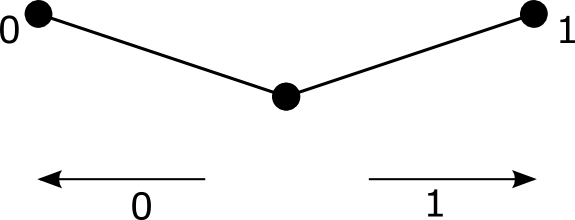
Obr. 15: Kořen a první patro binárního stromu.
Každá z těchto větví se stejným způsobem může rozdvojit v dalším uzlu. Uzly označujeme kódovými slovy, která reprezentují cestu, kterou jsme k nim ve stromu po hranách dorazili od kořene. Uzly, ze kterých již další větve nevedou, nazýváme listy.
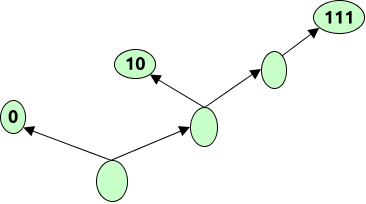
Tvorba prefixového kódu pomoci binárního stromu je založena na dvou předpokladech:
- Známe délku kódových slov, která má kód obsahovat.
- Kódová slova jsou ve stromu listy.
 Jak sestavíte binární strom prefixového
kódu, jehož kódová slova mají mít postupně délku 2, 1, 3?
4.3. Cvičení k vlastnostem prefixových kódů
Připomeňte si následující konkrétní příklad prefixového kódu:
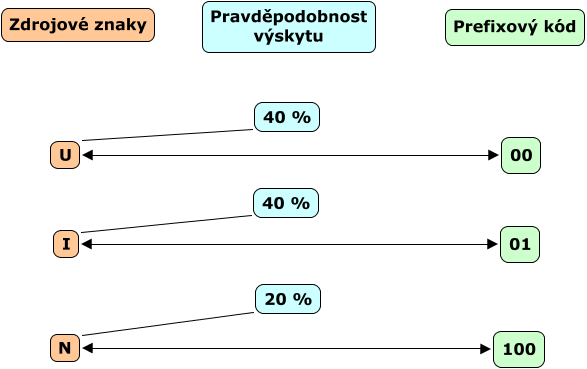
Obr. 14: Konkrétní příklad prefixového kódu. (Zdroj
vlastní)
- Určete průměrnou délku kódového slova a efektivnost daného kódu.
- Při pohledu na procentuální zastoupení znaků v daném kódu, by se mohl někdo chtít pokusit v rámci ještě větší úspory vytvořit prefixový nerovnoměrný kód s kódovými slovy, která budou všechna o jeden bit kratší. Zdůvodněte, zda je to možné?
Tipy pro řešení
Pomoci Vám může, pokud si připomenete důležité vzorce, které jsou shrnuté na obrázku níže.
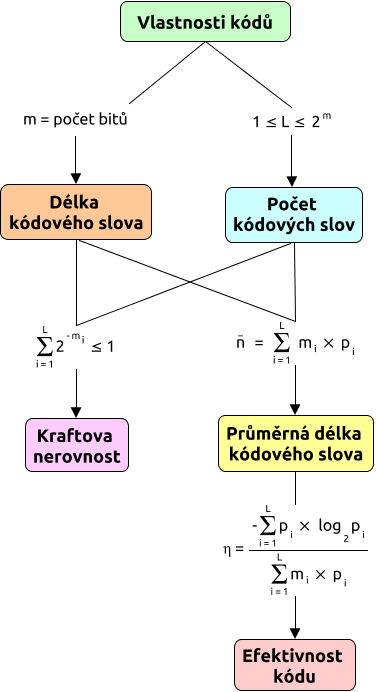
Obr. 5: Vlastnosti kódů se vzorci. (Zdroj
vlastní)
Návrh řešení
Na návrh řešení se podívejte, až se pokusíte spočítat (najít vysvětlení) pro nějaké vlastní.
 Jaká je průměrná délka kódového slova a efektivnost
kódu?
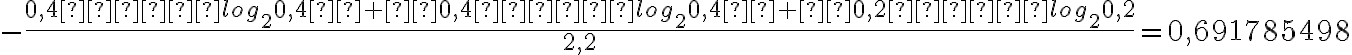
Bylo by možné pro zkrácení kódu ubrat
v každém kódovém slovu jeden bit tak, aby kód stále zůstal prefixový?
4.4. Shannon-Fano konstrukce
 Kromě binárního stromu
začaly být velmi brzy po ustanovení teorie informace C. E. Shannonem hledány efektivní způsoby, jak vytvářet prefixové kódy, pokud to Kraftova nerovnost dovolí. Jedna z metod, která byla vyvinuta již na pomezí let 1948 / 1949, nese jméno Shannon-Fano po tvůrcích, kteří ji publikovali nezávisle na sobě v mírně odlišných podobách.
Základní myšlenka je vždy stejná a spočívá v tom, přiradit znakům ze zdrojové abecedy kódová slova podle pravděpodobnosti výskytu ve zprávách,
které zdroj produkuje. Častěji se vyskytujícím znakům jsou přiřazena kratší kódová slova a naopak.
Obr. 18: Roberto Mario Fano. (Zdroj 121a0012, CC BY 3.0,
via Wikimedia Commons).
 Kromě pravděpodovnosti výskytu znaků zdrojové
abecedy může být brána v potaz také absolutní četnost. Jaký je rozdíl mezi těmito dvěma případy?
Postup vytvoření efektivního prefixového kódu Shannon-Fano metodou vypadá obecně následovně:
- Pravděpodobnosti sestupně seřadíte.
- Znaky rozdělte podle pravděpodobností na dvě co nejpodobnější skupiny, pokud jde součet pravděpodobností v nich.
- Jedné skupině přiřaďte binární 1, druhé skupině přiřaďte binární 0.
- Kroky 2 a 3 opakujte do té doby, než budou všechny skupiny jednoprvkové.
Přidělování binárních čísel skupinám je nutné dodržet po celou dobu stejné (tedy horní skupině 1 a dolní 0, nebo po celou dobu naopak).
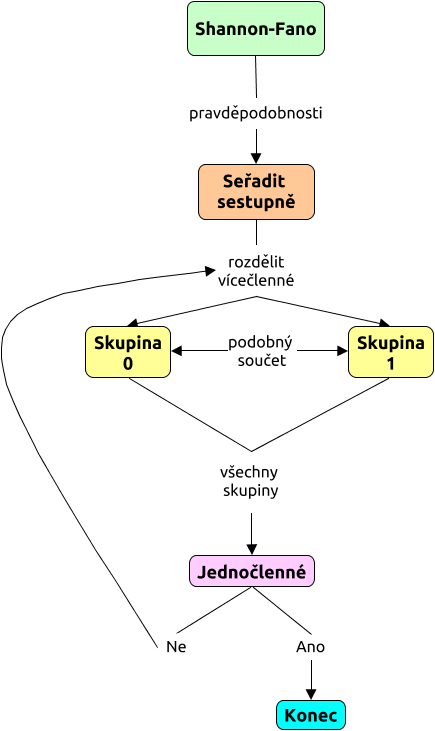
Obr. 19: Obecné schéma Shannon-Fano metody. (Zdroj: vlastní)
Jak podle uvedeného postupu zakódujete zdrojové
znaky D = 18 %, E = 36 %, F = 6 %, K = 10 %, P = 21 %, V = 9 %?
4.5. Huffmanova metoda konstrukce
V roce 1952 představil jinou konstrukci efektivního prefixového kódu David A. Huffman, který jako student doktorského studia reagoval o rok dříve na představení Shannon-Fano metody jedním z jejích tvůrců. Profesor Fano na jednom ze seminářů vyzval studenty, aby navrhli optimální řešení daného problému. Huffmanovo kódování se opravdu ukázalo být více efektivní, než způsob jeho učitele. Základní myšlenka zůstala stejná a spočívá v tom, přiradit znakům ze zdrojové abecedy kódová slova podle pravděpodobnosti výskytu ve zprávách, které zdroj produkuje. Častěji se vyskytujícím znakům jsou přiřazena kratší kódová slova a naopak.
Postup vytvoření efektivního prefixového kódu Huffmanovou metodou vypadá obecně následovně:
- Pravděpodobnosti sestupně seřadíte.
- Sečtete dvě nejmenší pravděpodobnosti.
- Nově získanou posloupnost pravděpodobností opět sestupně seřadíte (bude mít o jeden prvek méně než předchozí pravděpodobnost).
- Kroky 2 a 3 opakujete, dokud nezbude v posloupnosti pouze jediný prvek, kterým je 1 (vždy byste se měli dosčítat do 100 %).
- Začnete jít zpět s tím, že se podíváte na pravděpodobnosti, na které se rozpadá poslední sčítanec.
- Pravděpodobnosti, která byla ve sčítání a je v rámci řazení nahoře přidělíte na konec kódového slova např. binární 1.
- Pravděpodobnosti, která byla ve sčítání a je v rámci řazení dole přidělíte na konec kódového slova binární 0.
- Kroky 5 až 7 opakujete, dokud budou v posloupnosti nějaké pravděpodobnosti, které vznikly sčítáním.

Obr. 20: Obecné schéma Huffmanova kódování. (Zdroj vlastní)
Binární 1 a 0 můžete přidělovat v opačném pořadí (0 k horní pravděpodobnosti, 1 k dolní), ale je třeba to dělat po celou dobru stejně. Alternativou může být, že budete dávat k pravděpodobnostem binární 0 a 1 rovnou při cestě vpřed. I při této variantě kódová slova vytváříte odzadu (resp. právě umisťovaný bit dáváte na poslední místo).
 Jak podle uvedeného postupu zakódujete zdrojové
znaky D = 18 %, E = 36 %, F = 6 %, K = 10 %, P = 21 %, V = 9 %?
4.6. Cvičení k tvorbě efektivního prefixového kódu
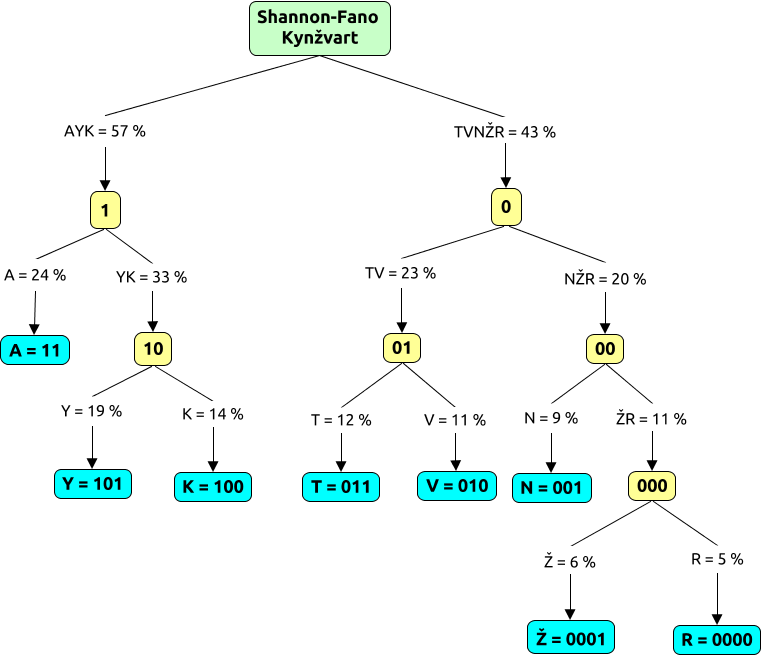
Znáte pravděpodobnost výskytu jednotlivých znaků: K = 14 %, Y = 19 %, N = 9 %, Ž = 6 %, V = 11 %, A = 24 %, R = 5 %, T = 12 %.
- Vytvořte efektivní prefixový kód Shannon-Fano metodou a spočítejte průměrnou délku kódového slova a efektivnost.
- Vytvořte efektivní prefixový kód Huffmanovou metodou a spočítejte průměrnou délku kódového slova a efektivnost.
Tipy pro řešení
Jak postupovat naleznete v předchozích studijních kapitolách. Pokud je u Shannon-Fano metody v nějaké fázi nejednoznačné dělení, stojí za to si vyzkoušet postupně obě možnosti a výpočtem vlastností porovnat, které bylo lepší uskutečnit. Totéž platí pro Huffmanovu metodu, pokud by došlo na nejasné řazení.
Návrh řešení
Na návrh řešení se podívejte, až se pokusíte vytvořit efektivní kód alespoň jedním způsobem u každé z metod.
 1. Jak může vypadat tvorba kódu se zadanými
pravděpodobnostmi Shannon-Fano metodou?
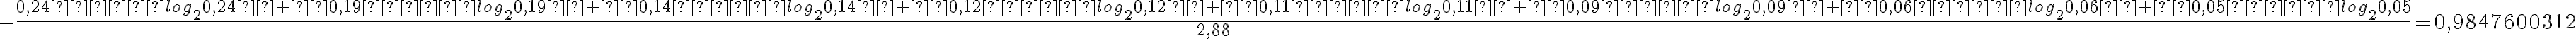
2. Jak může vypadat tvorba kódu se zadanými
pravděpodobnostmi Huffmanovou metodou?
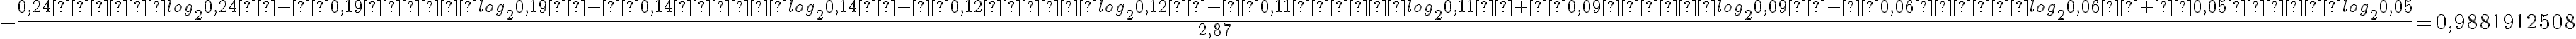
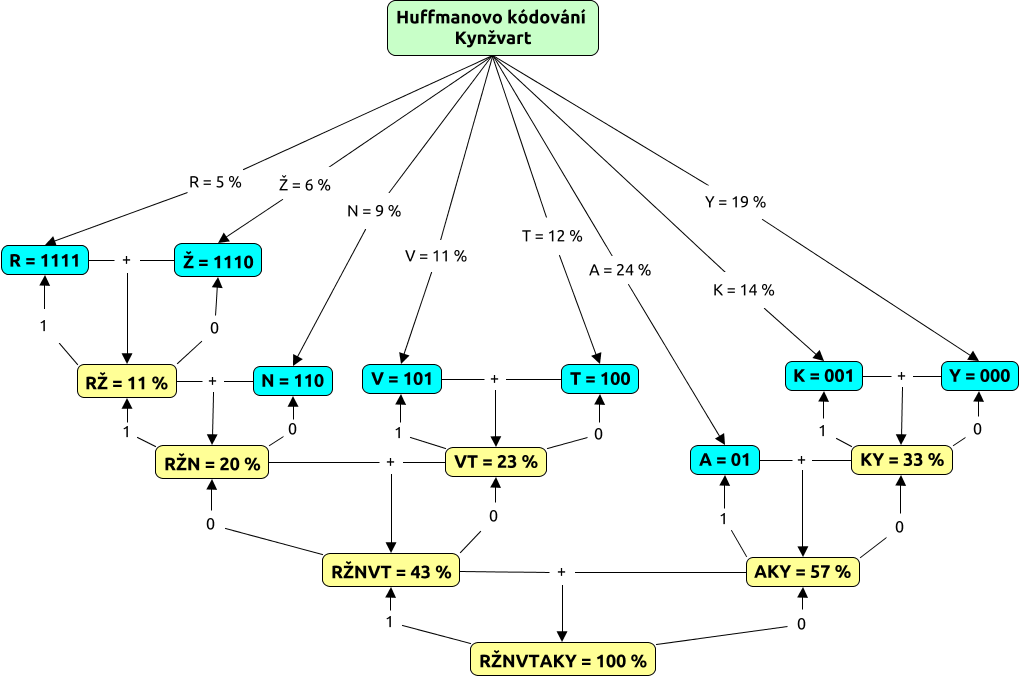
4.7. Shrnutí
 Nerovnoměrné kódy se vyznačují tím, že umožňují efektivněji využít přenosový kanál. Pokud platí Kraftova nerovnost, je možnost navíc je vytvořit jako kódy prefixové, které jsou snadno dekódovatelné. Pro konstrukci efekktivních prefixových kódů jsme ve studijní kapitole představili Shannon-Fano a Huffmanovu metodu. V první z nich se postupuje binárním stromem od kořene. Druhá dává stejné nebo lepší výsledky a binárním stromem se v ní postupuje od listů.
Zdroje
Podrobnější informace k tématu studijního článku můžete nalézt v následujících zdrojích:
- ADÁMEK, J. Kódování a teorie informace. Praha: ČVUT, 1991
- JIROUŠEK, Radim a kol. Principy digitální komunikace. Voznice: LEDA, 2006, 320 s. ISBN 80-7335-084-X.
- KOCOUREK, Petr a Jiří NOVÁK. Přenos informace. Praha: ČVUT Praha, 2004, 164 s. ISBN 80-010-2892-5.
- MAREŠ, Milan. Slova, která se hodí, aneb, Jak si povídat o matematice, kybernetice a informatice. Praha: Academia, 2006. 348 s. ISBN 80-200-1445-4.
- PROKOPOVÁ, Zdeňka. Základy informatiky: učební texty vysokých škol. Zlín: VUT v Brně, 1998, 98 s. ISBN 80-214-1129-5.
5. Typové příklady z kódování ke druhému testu
- Vytvořte symetrický váhový kód 541-1 pro kódování cifer desítkové soustavy. Všechny postupy zapište.
- Zjistěte, zda lze sestavit prefixový kód, když víte, že zdrojová abeceda má 7 znaků, které chcete postupně kódovat slovy o následujícím počtu bitů: 3, 2, 3, 4, 3, 2, 5. Pokud to možné, sestavte binární strom takového kódu.
- Na základě znalosti pravděpodobnosti výskytu znaků zdrojové abecedy sestavte optimální prefixový kód s pomocí Huffmanovy metody, zjistěte jeho charakteristiky a zakódujte slovo KANOPA: p(A) = 0,33, p(O) = 0,24, p(P) = 0,15, p(K) = 0,19, p(N) = 0,09.
Tipy pro řešení
Podívejte se do odpovídajících předchozích studijních kapitol a cvičení.
U prvního příkladu se přesvědčte, zda lze kombinací vah získat všechny cifry desítkové soustavy.
U druhého příkladu si spočtěte nejprve Kraftovu nerovnost.
U třetího příkladu si dejte pozor cestou vpřed na řazení po každém sečtení a při cestě zpět na přidělování bitů ke správným slovům.
Pokud se rozhodnete pro řešení v MS Excel, můžete s výhodou využít funkce SOUČIN.SKALÁRNÍ(), SUMA(), LOGZ(), POWER() a CONCAT().
Návrh řešení
 Postup řešení tentokrát cíleně nenabízíme, abyste
nebyli neustále zbytečně ovlivňováni. Pokud byste si zvoleným postupem nebyli jisti, samozřejmě kontaktujte vyučujícího (tutora). Po kliknutí zjistíte pro kontrolu alespoň výsledky, ale podívejte se na ně, až po pokusu
o vlastní řešení.