
Odstranění diakritiky
1. OdstraneniDiakritiky
1.1. Analýza a návrh řešení
Jak asi všichni víme, český jazyk používá diakritická znaménka k pozměnění významu písmene (odlišná výslovnost). Některé softwary mají s českou diakritikou problémy. Proto vytvoříme algoritmus, který ve svém hlavním programu zavolá podprogram (funkci) OdstranitDiakritiku, kterému je předán zadaný vstupní textový řetězec a tento podprogram odstraní všechna diakritická znaménka, tj. čárky, háčky nebo kroužky nad písmeny v tomto řetězci. Výsledný změněný řetězec navrátí zpět do hlavního programu, kde je spolu s úvodním textem vypsán - viz Obrázek 1.
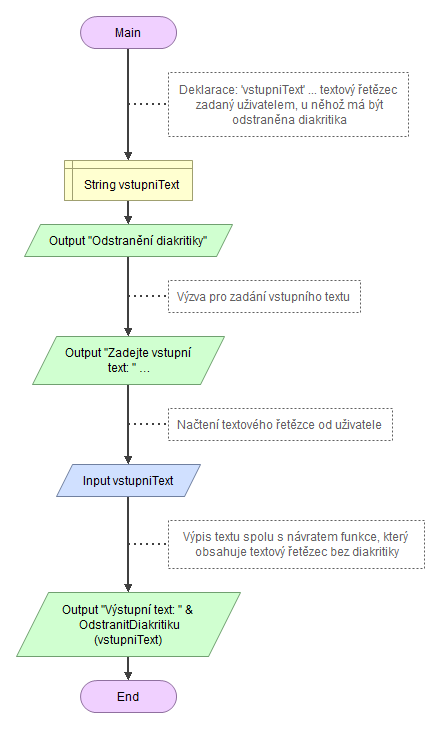
Obrázek 1: Hlavní program OdstraneniDiakritiky pro odstranění diakritických znamének ze vstupního textu
Podprogram OdstranitDiakritiku (viz Obrázek 3) využívá jednoduchého principu dvou textových řetězců, kde první textový řetězec sDiakritikou obsahuje jednotlivá písmena s diakritikou. Písmena bez diakritických znamének nejsou do textového řetězce sDiakritikou zahrnuta. Naproti tomu druhý textový řetězec bezDiakritiky obsahuje totožná písmena ve stejném pořadí, ale tentokrát bez diakritických znamének.
Jak již sám název textový řetězec napovídá, řetězec je tvořen jednotlivými po sobě jdoucími znaky. Jednotlivé znaky lze číst pomocí indexu určujícího pozici znaku v řetězci. Na dalším obrázku je ilustrován princip našeho algoritmu - viz Obrázek 2. Pokud znak ve vstupním řetězci bude shodný s nějakým znakem v prvním textovém řetězci s diakritikou např. na druhé pozici na znak 'á', nahradíme tento znak znakem na druhé pozici v řetězci bez diakritiky tj. znakem 'a'.
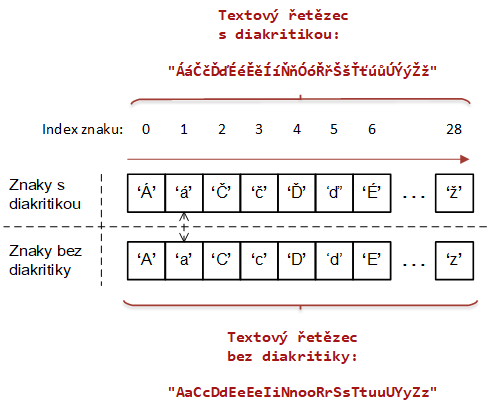
Obrázek 2: Princip záměny znaku s diakritikou za znak bez diakritiky
V další deklaraci podprogramu OdstranitDiakritiku je uvedena proměnná pocetZnaku, který nám slouží pro uložení počtu jednotlivých znaků v zadaném textovém řetězci od uživatele. Pro zjištění počtu znaků v textovém řetězci ve Flowgorithm využijeme funkce Len, která nám navrátí celé číslo. Další deklarovanou proměnou bezDia budeme využívat jako výstupní textový řetězec, do kterého budeme ukládat jednotlivé znaky bez diakritiky.
Po inicializaci prvního textového řetězce sDiakritikou obsahující jednotlivá písmena s diakritikou, budeme inicializovat druhý textový řetězec bezDiakritiky stejnými písmeny ve stejném pořadí, tentokrát však bez diakritiky. Po přiřazení prázdného textového řetězce do výstupního textového řetězce je do proměnné pocetZnaku přiřazena hodnota počtu znaků.
Tuto hodnotu následně využijeme v cyklu s krokem pro procházení jednotlivých znaků ve vstupním textovém řetězci s. Jak již bylo řečeno, ve Flowgorithm tak i v C# lze procházet jednotlivé znaky textového řetězce pomocí indexu (pozice znaku v textovém řetězci). Pro tento účel využijeme ve Flowgorithm funkci Char, která navrací znak na specifikované pozici. Tato funkce přijímá dva vstupy - textový řetězec a index znaku, který požadujeme navrátit. V cyklu pomocí řídící proměnné i budeme testovat, zda znak na i-té pozici ve vstupním textovém řetězci s je obsažen v textovém řetězci sDiakritikou. Pokud ano, budeme procházet pomocí řídící proměnné j jednotlivé znaky obsažené v textovém řetězci s diakritikou a budeme je testovat na shodu se znakem na i-té pozici ve vstupním textovém řetězci s. Pokud nastane shoda, připojíme znak z řetězce bezDiakritiky na stejné pozici j, na které byl znak vyhledán v řetězci sDiakritikou (prohození znaku s diakritikou za znak bez diakritiky).
Pokud textový řetězec s diakritikou neobsahuje testovaný znak na i-té pozici ve vstupním textovém řetězci s, je do výstupního textového řetězce bezDia připojen znak ze vstupního řetězce s na pozici i.
Posledním krokem je přiřazení výsledného textového řetězce bezDia návratu funkce OdstranitDiakritiku - viz Obrázek 3.

Obrázek 3: Podprogram OdstranitDiakritiku - funkce pro odstranění diakritických znamének
Vzhledem k tomu, že C# obsahuje metodu Contains třídy string, nahradíme tuto funkčnost jazyka pomocí vlastní funkce, které předáme dva parametry:
- znak - znak, který má být vyhledán v textovém řetězci text
- text - text představující prohledávaný textový řetězec
V rámci deklarace budeme deklarovat následující proměnné: vyskyt logická proměnná představující informaci, zda se vyskytl znak v textovém řetězci text a další lokální proměnnou i, která představuje pozici znaku v textovém řetězci - viz Obrázek 4. Po inicializaci logické proměnné na hodnotu false (znak se nenachází v prohledávaném textovém řetězci), budeme procházet jednotlivé znaky umístěné v textovém řetězci text. Abychom zajistili, že bude pomocí cyklu vyhledáván pouze jeden znak (ve Flowgorithm není deklarován typ char jako v C#, ale pouze typ String), použijeme pouze první znak (index 0) v textovém řetězci znak.
Pokud je znak shodný s nějaký znakem v textovém řetězci, přiřadíme do proměnné vyskyt hodnotu true, která představuje informaci (a také návrat funkce samé), že zadaný znak byl v textovém řetězci nalezen.
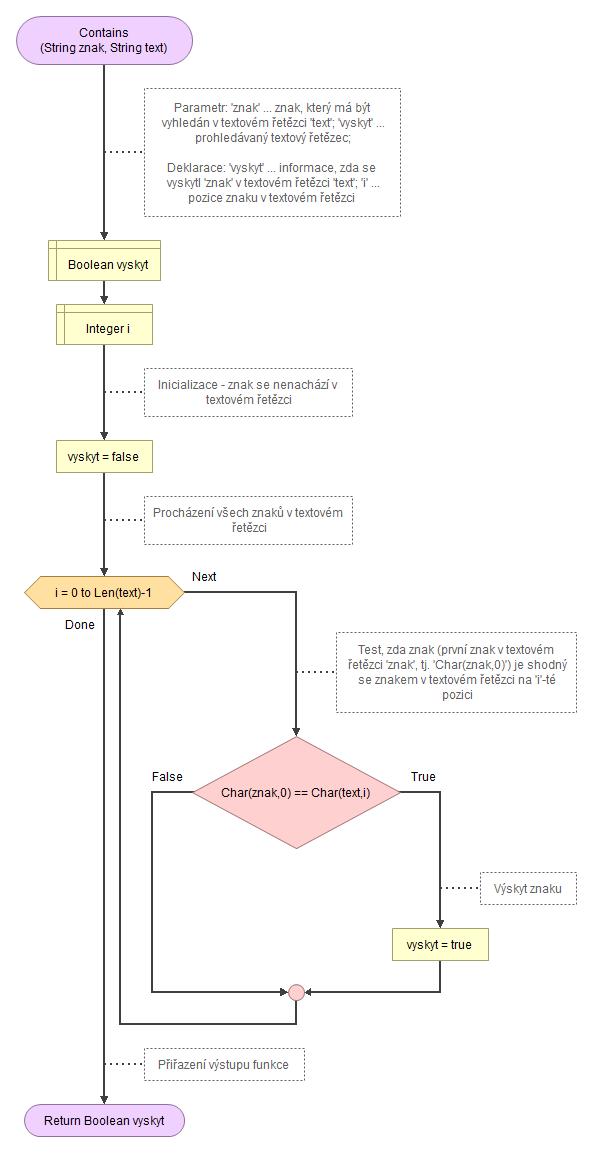
Obrázek 4: Podprogram Contains - funkce testování výskytu znaku v textovém řetězci