
Základní pojmy
Při programování je třeba si uvědomit, že různé datové typy mají také různé rozsahy hodnot, tzn. různé dolní a horní meze. Při překročení rozsahu během aritmetických výpočtů mohou nastat různé problémy. Uvidíme, že reálná čísla jsou ukládána jen přibližně, což může mít vliv zejména na přesnost opakovaných výpočtů.
3. Kódování jednotlivých znaků
Obvykle 1 údaj (znak) zabere
1 byte paměti. Existují různé způsoby kódování, tj. způsoby zobrazení znaků v
počítači. V praxi se ustálilo použití pouze několika systémů kódování, z nichž
nejpoužívanější je: ASCII kód.
ASCII -zkratka American Standard Code for Information Interchange – znamená americký standardní kód pro výměnu informací. V podstatě jde o kódovou tabulku, která definuje znaky anglické abecedy a jiné znaky používané v informatice. ASCII kód byl vytvořen v roce 1963 a obsahoval pouze velká písmena a čísla. V roce 1967 byla přidána malá písmena a znaky na 7 bitech (hodnota 0 -127 odpovídá pozici znaku) - viz norma ISO 6429 (kód se také označuje ISO-7).
Nevýhodou ASCII kódu je, že kód definuje pouze znaky anglické abecedy a nedokáže obsáhnout znaky národních abeced. Rozšířením na 8 bitů se získá kód, který se používá jako vnitřní kód (umožňuje použít specifické znaky pro daný jazyk – většinou s diakritikou). Asi tabulku nevědomky běžně využíváte, když stlačíte klávesu ALT +zadáte číselný kód (např. Alt + 64 vám na české klávesnici vypíše znak na pozici 64, tj. „@“).
Kód definuje celkem 256 znaků s hodnotou 0 ÷ 255, kde znaky v rozsahu:
- 0 ÷ 31 jsou tzv. řídící znaky
- 32 ÷ 126 zobrazitelné znaky
- 127 e definován normou jako řídící znak DEL - viz Tabulka 1.
- 128 ÷ 255 jako speciální znaky. Speciální znaky definující řadu semigrafických znaků a znaky národních abeced. Podle toho pak existují národní modifikace ASCII kódu, např. kód IBM PC-Latin 2 (ČSN 9103/89), ISO Latin 2 (ISO 8859-2), který obsahuje české znaky s diakritikou, např. č, ř, á, ě apod. Ve střední Evropě se pro kódování používá sada ISO 1250 - viz Tabulka 2.
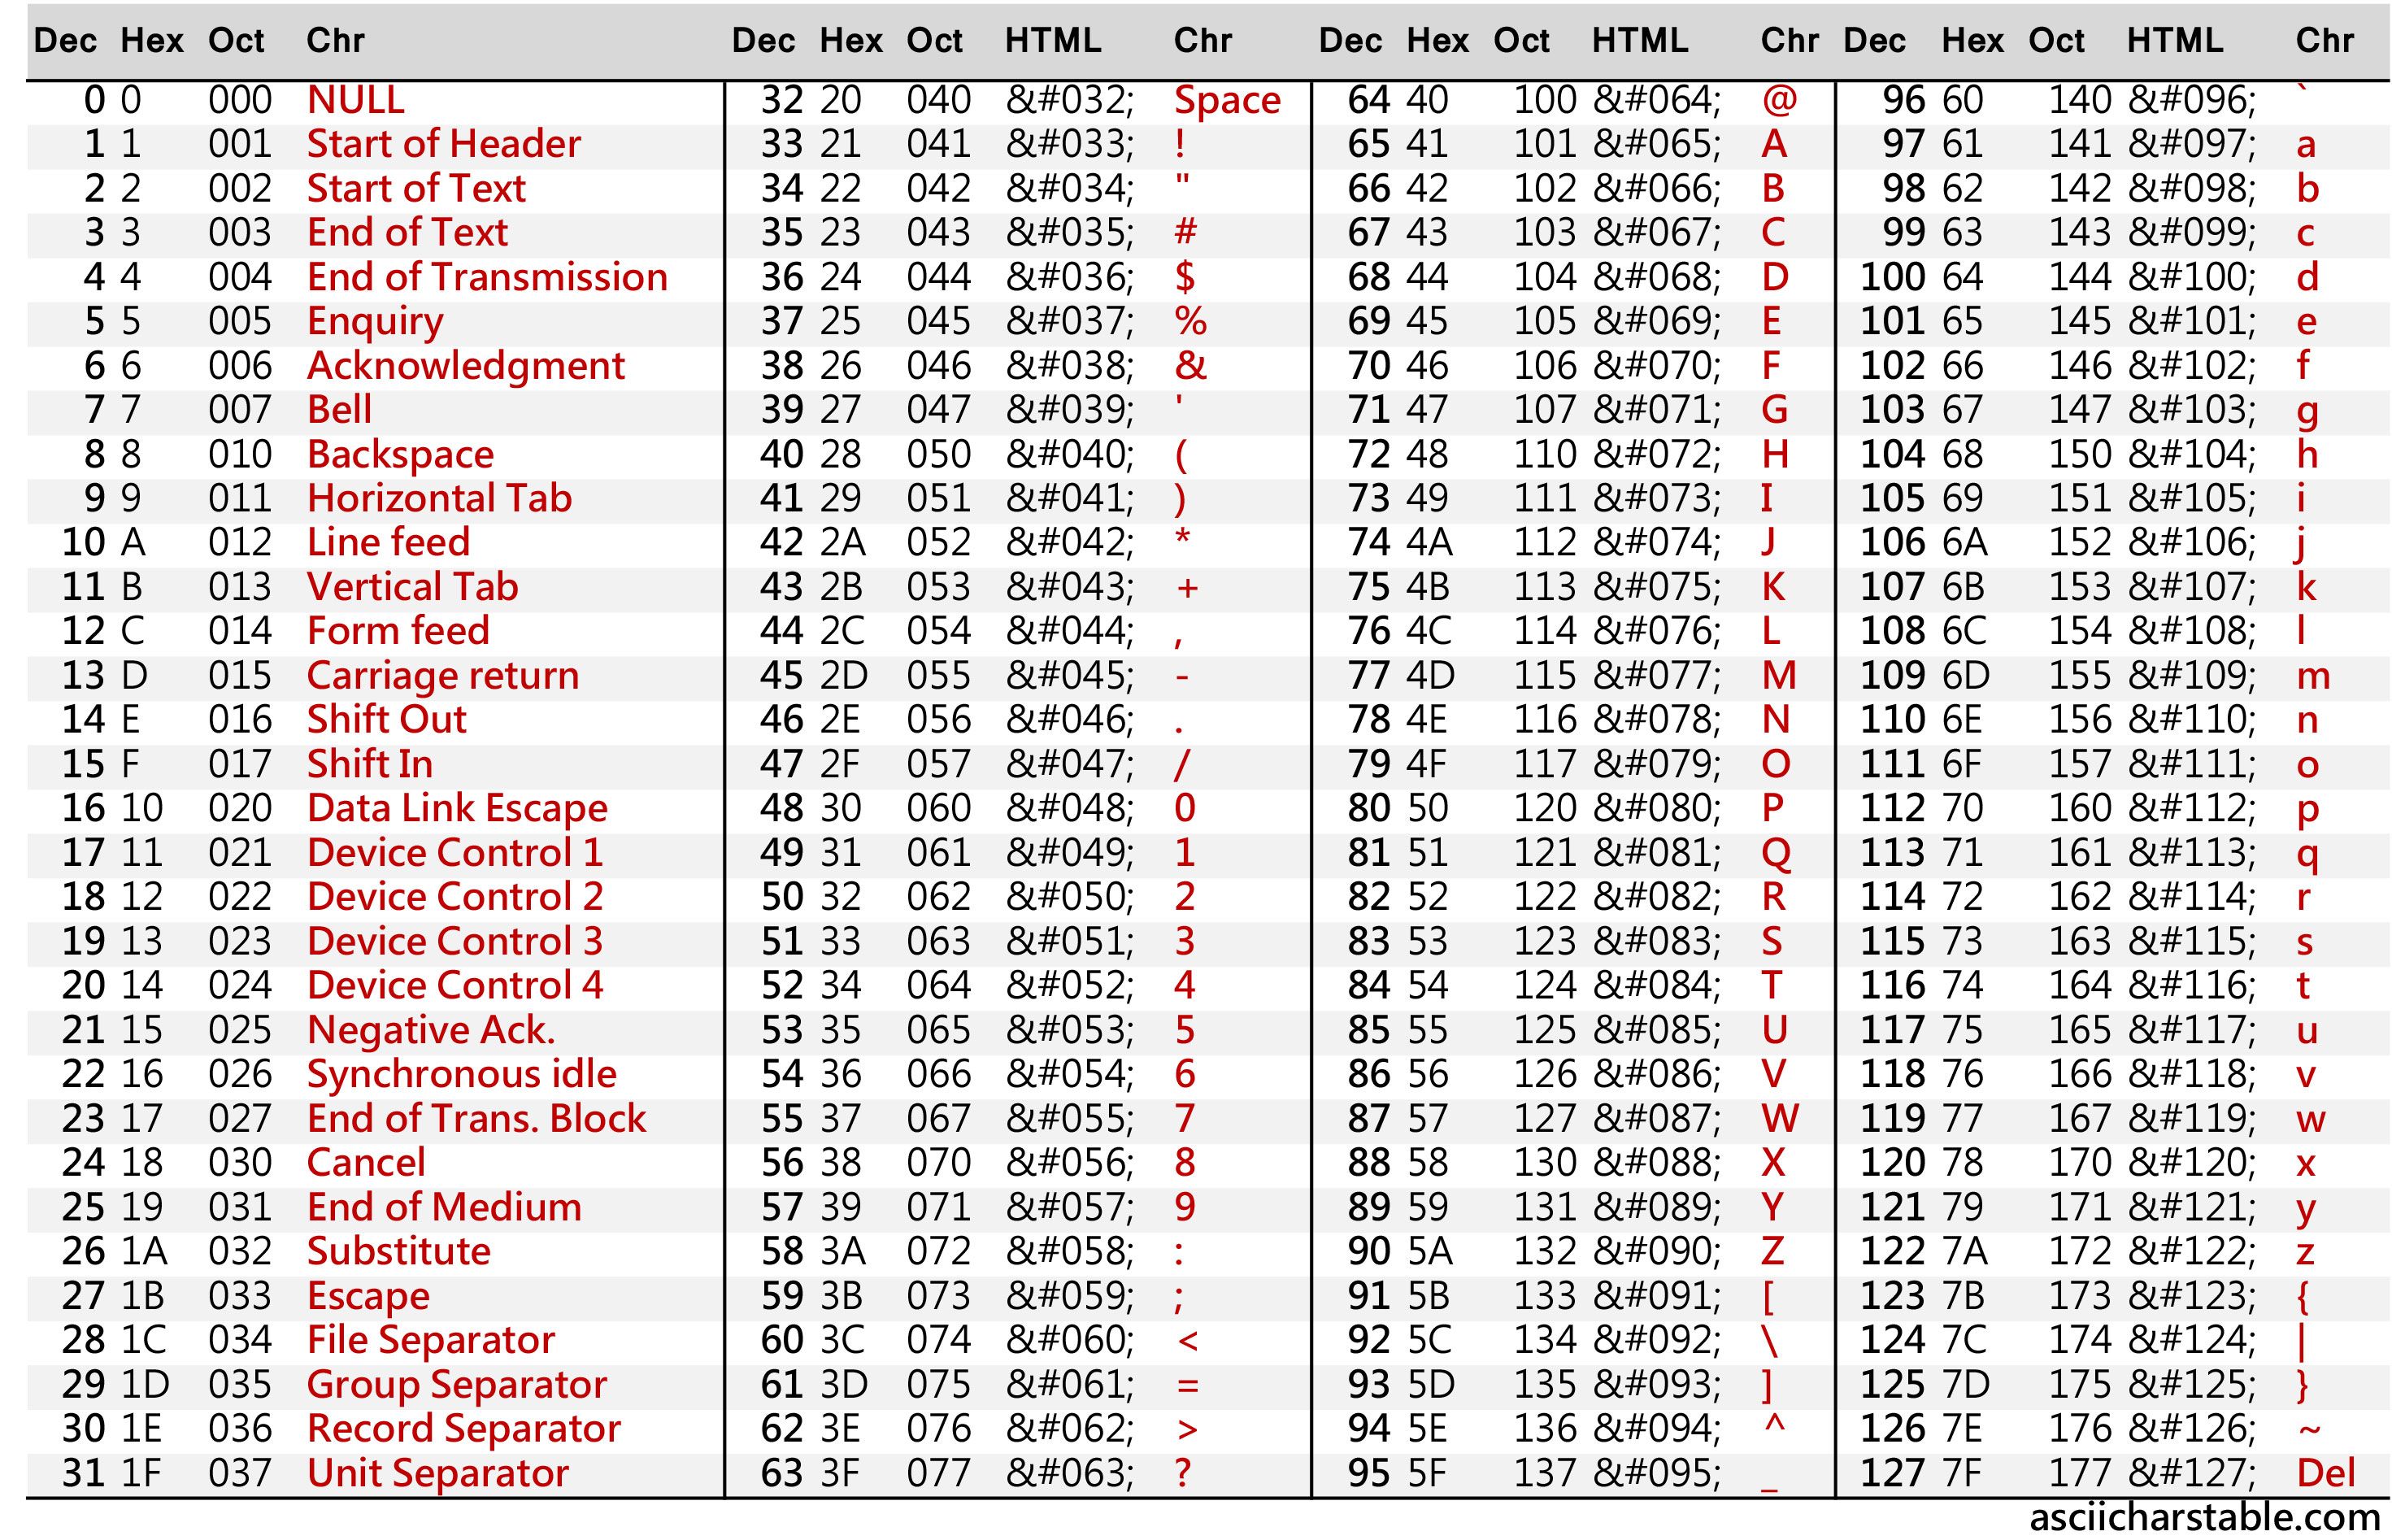
Tabulka 1: ASCII tabulka – rozsah znaků 0 ÷ 127 [4]
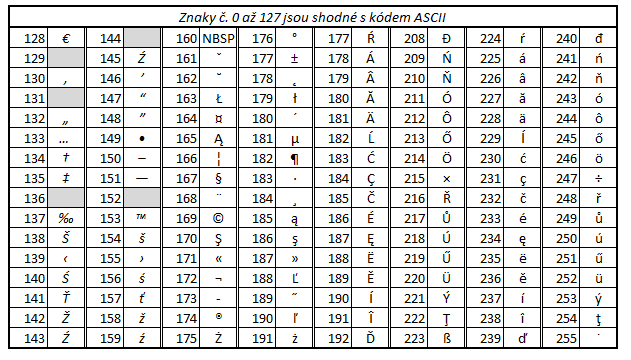
Tabulka 2: ASCII tabulka Windows 1250 – rozsah znaků 128 ÷ 255 [5]
Unicode – problém jednotného kódování do národních znaků se snaží vyřešit kódování Unicode. Unicode přiřazuje každému znaku jedinečné číslo, nezávisle na platformě, nezávisle na programu, nezávisle na jazyku. Často se používá pro presentace na Webu. Existují 3 druhy kódování Unicode:
- UTF-8 pracuje s osmibitovým kódováním, jeden znak může být vyjádřen jedním až čtyřmi byty, znaky bez diakritiky jsou obvykle vyjádřeny jedním bytem
- UTF-16 pracuje se šestnáctibitovým kódování
- UTF-32 pracuje se s dvaatřicetibitovým kódováním znaků, znaky bez diakritiky mohou obsahovat 24 nulových bitů a 8 nenulových bitů shodných s ASCII
Pozn.: Někdy je jeden znak ukládán ve dvou bytech. Pak druhý byte může obsahovat např. vlastnosti pro zobrazení znaku (velikost, tučnost, kurzívu atd.).
Algoritmus HexadecimalniPrevodPodprogramValidaceZnakNaPoziciASCIIPoziceZnakuASCII
- Popis: Vývojový diagram převodu čísla z desítkové do šestnáctkové soustavy zobrazené v 1 Bytu
- Zadání: Zkuste vymyslet algoritmus, který převede číslo z intervalu 0 až 255 zadané v desítkové soustavě do šestnáctkové soustavy včetně funkce Validace zadaného čísla. Dále specifikujte funkci pro určení znaku na určité pozici v ASCII - ZnakNaPoziciASCII - na číslo a obráceně, tj. navrácení pozice určitého znaku - PoziceZnakuASCII
- Řešení:
- Podprogramy - funkce:
Asi vnímáte, že podstata našeho úkolu je stejná jako v předchozím případu převodu z desítkové do dvojkové soustavy. Hlavní rozdíl je v celočíselném dělení a zbytku po celočíselném dělení hodnotou 16, namísto hodnoty 2. Pak vyvstává otázka, proč je tento příklad zařazen zrovna do této kapitoly? Jak jste se již dočetli, šestnáctková (hexadecimální) soustava využívá jak číslice, tak i písmena. U předchozího příkladu jsme použili pro připojení textu "1" nebo "0" rozhodovací blok, který testoval, zda zbytek po celočíselném dělení hodnotou 2 je roven 0. Pokud ano, vložili jsme textový řetězec "0". Jak jste si mohli, všimnout v tabulkách ASCII jsou zastoupeny na jednotlivých pozicích určitým znakem – datový typ String (přesněji řečeno datový typ Char, který představuje znak - v C# je znak uváděn v jednoduchých, např. 'A'. Datový typ Char není ve Flowgorithm definován, proto využijeme datový typ String). Textový řetězec (datový typ String) obsahuje řetězec jednotlivých znaků poskládaných za sebou, uvozený a zakončený dvojitými uvozovkami. Lze tedy do něj psát i věty.
Vraťme se ale zpět k našemu nynějšímu zadání. Pokud zbytek po celočíselném dělení hodnotou 16 je větší než 9 (šestnáctková soustava obsahuje číslice "0" - "9") potřebujeme do textového řetězce připojit znak podle výše zbytku (znak "A" představuje hodnotu 10 u zbytku celočíselné dělení, znak "B" představuje hodnotu 11 atd. až znak "F" představuje konečnou hodnotu 15). Pro vložení znaku do hexadecimálního řetězce můžeme ve vývojovém diagramu např. využít více rozhodovacích bloků, kde bychom podle výše zbytku vkládali jednotlivá písmena, nebo vícenásobné větvení apod. My ale využijeme ASCII kódování (tabulku znaků), kde podle výše zbytku celočíselného dělení budeme vkládat z ASCII tabulky jednotlivé znaky. Abychom tento princip mohli využít, potřebujeme vytvořit podprogram ve formě funkce, který nám bude vracet hodnotu znaku nalezeného na určité pozici v ASCII. Tuto funkci navracející znak nazveme ZnakNaPoziciASCII.
Do této funkce budeme předávat celočíselný parametr předávaný hodnotou pojmenovaný:
- pozice – číslo pozice znaku, který hledáme v ASCII (datový typ Integer)
Ve funkci dále využijeme lokální proměnnou:
- znak – znak nalezený na určité pozici v ASCII (datový typ String)
Princip této funkce pro vyhledání znaku na specifikované pozici je, že celočíselný parametr pozice, který do funkce vstupuje je přetypován – konvertován, tj. převeden z datového typu Integer do jiného datového typu String. Výstupem funkce je vyhledaný znak (textový řetězec o jednom znaku) na zadané pozici.
Pro algoritmus budeme dále potřebovat opačný způsob, kdy do funkce vložíme znak a obdržíme pozici znaku v ASCII. Tuto funkci nám bude zajišťovat funkce PoziceZnakuASCII. Tento podprogram má následující vstupní parametr:
- znak – znak hledaný na určité pozici v ASCII (datový typ String)
Ve funkci využijeme lokální proměnnou:
- pozice – číslo pozice znaku, který hledáme v ASCII (datový typ Integer)
Princip funkce je téměř totožný s předchozí funkcí. Rozdílem je přetypování vstupního znaku na celé číslo, tím obdržíme pozici, na které se znak nachází.
Podstata algoritmu hexadecimálního převodu je téměř totožná s převodem do dvojkové soustavy. Hlavní rozdíl je celočíselné dělení a zbytek po celočíselném dělení hodnotou 16. Pro algoritmus jsou deklarovány následující lokální proměnné:
- decimalniHodnota – celočíselná hodnota v desítkové soustavě načtená z funkce Validace, která je totožná s funkcí Validace využité v převodu do binární soustavy (datový typ Integer)
- zbytek – celočíselná hodnota zbytku po celočíselném dělení 16 (datový typ Integer)
- hexadecimalniText – textový řetězec jenž představuje konvertované číslo z desítkové do šestnáctkové soustavy (datový typ String)
Hlavní podstatou, kterou nám tento příklad ukazuje, je následný proces přiřazení (výraz) po rozhodovacím bloku, který testuje zbytek po celočíselném dělení hodnotou 16. Jestliže tento zbytek je větší než 9, měli bychom namísto hodnoty vložit písmeno (znak), podle výše zbytku. Využijeme funkce pro obdržení znaku na určité pozici. Tato pozice je spočtena jako zbytek + PoziceZnakuASCII("A") – 10, tzn., že součet vypočtené zbytku po celočíselném dělení a rozdílu hodnoty 10 od pozice znaku "A" obdržené z funkce PoziceZnakuASCII. Tím získáme počet, o kolik pozic se máme posunout od znaku "A", abychom získali jednotlivý znak vyjadřujícím zbytek po celočíselném dělení. Pokud se pohybujeme v rámci číslic, tzn., není splněna podmínka většího než 9 (větev False vedoucí z rozhodovacího bloku), budeme pro určení počtu pozic, abychom obdrželi číslice využívat startovací pozici znaku "0". Výraz je následující hexadecimalniText = ZnakNaPoziciASCII(zbytek + PoziceZnakuASCII("0")) & hexadecimalniText. Obdržené znaky připojujeme do textového řetězce hexadecimalniText zleva. Ostatní bloky již byly popsány u příkladu převodu do binární soustavy.