
Základní pojmy
Při programování je třeba si uvědomit, že různé datové typy mají také různé rozsahy hodnot, tzn. různé dolní a horní meze. Při překročení rozsahu během aritmetických výpočtů mohou nastat různé problémy. Uvidíme, že reálná čísla jsou ukládána jen přibližně, což může mít vliv zejména na přesnost opakovaných výpočtů.
4. Typy dat
4.5. Ilustrace nepřesného zobrazení
V řadě iteračních úloh
mohou chyby ze zaokrouhlení způsobit zhroucení výpočtu. Na
následujícím příkladu si ukážeme vliv nepřesnosti reálného čísla, což může vést
k chybným výsledkům. Tento příklad však potřebuje různé datové typy pro uložení hodnoty reálného čísla, což v aplikaci Flowgorithm nelze, protože obsahuje pouze datový typ Real.
Algoritmus NepresneZobrazeni
- Popis: Vývojový diagram nepřesnosti zobrazení reálného čísla
- Zadání: Vymyslete algoritmus, který poukáže na nepřesnost zobrazení reálného čísla v závislosti na zvoleném datovém typu. Pro reálné číslo uložené v proměnné x zvolte datový typ float a pro proměnnou y zvolte datový typ double. Pro ilustraci nepřesnosti zvolte hodnotu výrazu x = (n+1) * x – 1. V každé iteraci pro jednotlivá n bude do výrazu vložena hodnota proměnné x, která odpovídá výrazu x = 1/n. Zvolte dva cykly s krokem, kde vnořený cyklus proběhne 30-krát pro každou hodnotu n. Tento vnořený cyklus bude zaznamenávat číslo iterace pomocí proměnné iterace. Ve vnějším cyklu bude postupně nastavena hodnota proměnné n od 1 do 10. Výsledek umístěný na řádku pro každou iteraci bude obsahovat aktuální hodnotu proměnných n; iterace; x; y. U výpisu výsledků za každou 10 řádku vložte prázdnou řádku
Řešení:
Vzhledem k tomu, že Flowgorithm v současné době nedisponuje možností výběru z různých datových typů, je pomocí následujícího odkazu zobrazen vývojový diagram vytvořený v aplikaci Visio od společnosti Microsoft, která umožňuje vytvářet vlastní vývojové digramy, ale neumožňuje z nich generovat kód do různých programovacích jazyků.
Jak bylo řečeno v zadání, do reálné proměnné x uložíme hodnotu 1/n, kde n je celé číslo. Potom budeme v každé iteraci vnitřního cyklu opakovaně vypočítávat výraz (n+1) * x - 1. Pokud tento výraz upravíme dosazením za x = 1/n, obdržíme (n+1)* 1/n – 1. Po vynásobení, odstranění závorek a provedení sčítání a odečítání, obdržíme opět 1/n.
Pokud však neprovedeme algebraické úpravy, ale budeme opakovaně provádět výpočty (n+1) * x - 1, dojde k tomu, že přesný výsledek 1/n obdržíme jen pro n = 2k, kde k = 0,1,2, ... Pro jiná n dojde k divergenci a získáme zcela nesprávný výsledek již po několika (10–30) opakováních, a to nezávisle na programovacím jazyku a přesnosti zobrazení reálného čísla.
Pro algoritmus jsou deklarovány následující lokální proměnné:
- iterace – číslo iterace (v C# datový typ int)
- n – celé číslo ve vnějším cyklu představuje dělitele, ve vnitřním cyklu hodnotu umístěnou ve výrazu v závorce (datový typ int)
- x – reálné číslo – velikost 4 Byte, přesnost 7 číslic, rozsah čísel od ±1.5*10-45 do ±3.4*1038 (v C# datový typ float)
- y – reálné číslo – velikost 8 Byte, přesnost 15–16 číslic, rozsah čísel od ±5.0*10-324 do ±1.7*10308 (v C# datový typ double)
Algoritmus se skládá ze dvou cyklů. Vnější cyklus zajišťuje změnu hodnoty proměnné n od hodnoty 1 do hodnoty 10. V tomto cyklu jsou nastaveny počáteční hodnoty proměnné x a y pomocí výrazu 1/n. Ve vnitřním (zapouzdřeném) cyklu je v první iteraci provedeno dosazení počáteční hodnoty z proměnné x do výrazu (n+1)*x– 1. V další iteraci (iteracích) je již dosazována vypočtená aktuální hodnota uložená v proměnné x (tato hodnota byla spočtena v předchozí iteraci). Stejný postup je aplikován i na výpočet hodnoty u proměnné y. Kvůli zvýšení čitelnosti výsledků jednotlivých iterací je zajištěno vložení prázdné řádky po každých deseti vypsaných řádcích s výsledky. Podmínka specifikovaná uvnitř rozhodovacího bloku tedy testuje, zda již proběhlo 10 iterací.
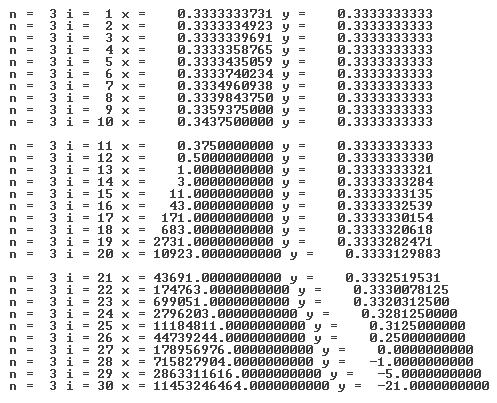
Výstup algoritmu - Nepřesnost zobrazení reálného čísla (viz NepresneZobrazeni)