
Kódování
4. Nerovnoměrné kódy
4.4. Shannon-Fano konstrukce
 Kromě binárního stromu
začaly být velmi brzy po ustanovení teorie informace C. E. Shannonem hledány efektivní způsoby, jak vytvářet prefixové kódy, pokud to Kraftova nerovnost dovolí. Jedna z metod, která byla vyvinuta již na pomezí let 1948 / 1949, nese jméno Shannon-Fano po tvůrcích, kteří ji publikovali nezávisle na sobě v mírně odlišných podobách.
Základní myšlenka je vždy stejná a spočívá v tom, přiradit znakům ze zdrojové abecedy kódová slova podle pravděpodobnosti výskytu ve zprávách,
které zdroj produkuje. Častěji se vyskytujícím znakům jsou přiřazena kratší kódová slova a naopak.
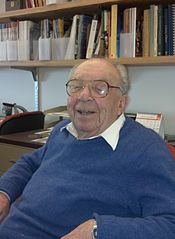
Obr. 18: Roberto Mario Fano. (Zdroj 121a0012, CC BY 3.0,
via Wikimedia Commons).
 Kromě pravděpodovnosti výskytu znaků zdrojové
abecedy může být brána v potaz také absolutní četnost. Jaký je rozdíl mezi těmito dvěma případy?
Postup vytvoření efektivního prefixového kódu Shannon-Fano metodou vypadá obecně následovně:
- Pravděpodobnosti sestupně seřadíte.
- Znaky rozdělte podle pravděpodobností na dvě co nejpodobnější skupiny, pokud jde součet pravděpodobností v nich.
- Jedné skupině přiřaďte binární 1, druhé skupině přiřaďte binární 0.
- Kroky 2 a 3 opakujte do té doby, než budou všechny skupiny jednoprvkové.
Přidělování binárních čísel skupinám je nutné dodržet po celou dobu stejné (tedy horní skupině 1 a dolní 0, nebo po celou dobu naopak).
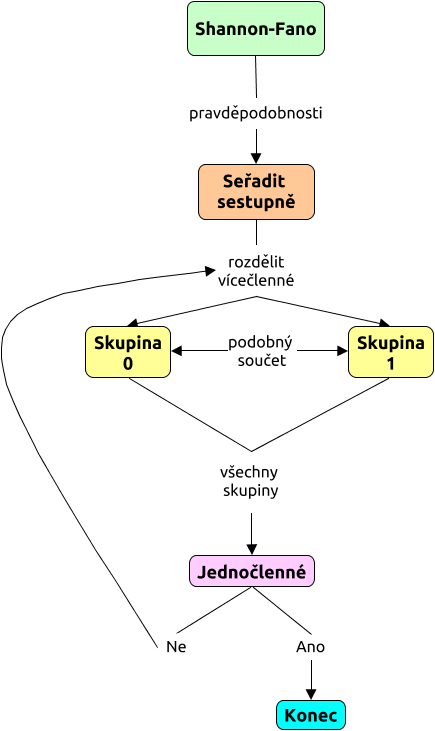
Obr. 19: Obecné schéma Shannon-Fano metody. (Zdroj: vlastní)
Jak podle uvedeného postupu zakódujete zdrojové
znaky D = 18 %, E = 36 %, F = 6 %, K = 10 %, P = 21 %, V = 9 %?